小白极简强化学习方案
·
如果你是一个小白(本科生或研究生或···),你会使用python (*^_^*)
恭喜你,你已经拥有了强化学习需要的所有基本技能(复制并运行代码)。🎉
我将为你介绍轻量级物理仿真平台 deephonor-gym(DHGym),一个小型的python库。
这个库目前实现了一些核心功能,适合作为算法快速验证、urdf文件查看的小工具。
题外话:由于本库为作者业余时间制作,所以开发进度缓慢。截至2025年9月,关于此库的使用问题有问必答(邮箱:m17797618108@163.com)
安装
需要的 python 依赖为:deephonor-gym,gymnasium
如果想要训练机器人那么 stable_baselines3 将非常好用
请确保你能正确下载上述的python库
pip install deephonor-gym
使用
- 第一步,通过 open_browser 打开 DHGym,此时会出现空荡荡的页面,别急,第三、四步有结果(点击 start 按钮会尝试与 DHGym 连接)
from deephonor_gym import open_browser,Upload
open_browser() # 打开我们的仿真平台

Upload('models','models') # 仅需要执行一次,推荐放在'models'下面,用到什么放什么
如果你没有urdf模型,可以从gitee/github上找找,比如 > 示例文件及教程路径
- 第二步,建立你自己的环境,编写好 init,explain_obs,explain_action,explain_reset,reward 这五个函数,在下面的代码基础上修改就行,适配你自己的 urdf 文件
import gymnasium as gym
import numpy as np
from deephonor_gym import DHgym,DHgym_VecEnv

class myEnv(DHgym) :
    """用户自己写的代码"""
    def init(self):
        self.num_envs = 40 # 同时控制 20 个 env
        self.render_fps = 30 # 控制频率

        self.action_space = gym.spaces.Discrete(5) # 0, 1, 2,3,4:

        self.info_array = [{"counts":0} for _ in range(self.num_envs)]

        # x,z,vx,vz
        low = [-10 , -10 ,-200,-200]
        high = [10 , 10, 200, 200]
        self.observation_space = gym.spaces.Box(
            low  = np.array(low ,dtype=np.float32),
            high = np.array(high,dtype=np.float32)
            )# 确定上下界

        add_obj = {} # 以下参数均可选,除了path
        add_obj['world'] = {'gravity':[0, -9.81, 0],'speed':1, 'QuatType':'Mujoco' } # optional 可选 speed > 0.01
        # add_obj['Heightground'] = {'size':[30,30,10],'position':[0,0,0],'path': '/models/heightground.jpeg', 'detail': 100 } # optional 可选 detail >= 1
        add_obj['urdf'] = [
                            {'scale':1,'position':[2,1,0],'path': '/models/ball.urdf','debug':True } # 使用之前别忘了 Upload 模型到web端
                            # {'scale':1,'position':[0,2,0],'path': '/models/T12/urdf/T12.URDF','debug':True,'JointDamping': 1000 },
                          ]
        add_obj['Ground'] = {'size':[20,20] ,'position':[0,0,0]} # optional 可选 如果 不用 Heightground

        obs_target = []
        obs_target.append('sphere_robot.Link.ball') # (x,y,z,vx,vy,vz, q1,q2,q3,w ,avx,avy,avz)-> 13
        # obs_target.append('sphere_robot.Link.*') # 全部

        return add_obj, obs_target

    def explain_obs(self,obs):
        """将obs格式解释为state的格式"""
        state = np.zeros((self.num_envs,4),dtype=np.float32)
        for i in range( self.num_envs):
            x,_,z,vx,_,vz,q1,q2,q3,w,ax,_,az = obs[i]
            state[i, 0] = x
            state[i, 1] = z
            state[i, 2] = vx
            state[i, 3] = vz
        return state

    def explain_action(self,action):
        """说明需要哪些信息"""
        explain = []
        for i in range(self.num_envs):
            force = {}
            if action[i]==0:
                force['sphere_robot.Impulse.ball'] = [10,0,0]
            elif action[i]==1:
                force['sphere_robot.Impulse.ball'] = [-10,0,0]
            elif action[i]==2:
                force['sphere_robot.Impulse.ball'] = [0,0,10]
            elif action[i]==3:
                force['sphere_robot.Impulse.ball'] = [0,0,-10]
            elif action[i]==4:
                force['sphere_robot.Impulse.ball'] = [0,0,0]
            explain.append(force)

        # 如果是力的话按照下面的格式
        # for i in range(self.num_envs):
        #     force = {}
        #     force['Joint.KP1'] = action[i]/3 # 随便给的力
        #     force['Joint.KP2'] = action[i]/3
        #     force['Joint.KP4'] = action[i]/3
        #     force['Joint.KP5'] = action[i]/3
        #     explain.append(force)
        return explain


    def reward(self,state):
        reward_array  = np.full(self.num_envs,0,dtype=np.float32)
        terminated = np.full(self.num_envs,False,dtype=bool)
        truncated  = np.full(self.num_envs,False,dtype=bool)
        reset_array = np.full(self.num_envs,False,dtype=bool)

        for i in range( self.num_envs):
            info = self.info_array[i]

            x,y,vx,vy = state[i]
            info["counts"] += 1

            distance = np.abs(np.array([x, y])).sum()
            Done = (distance<=1) or (distance >= 20)
            if not Done:
                reward =  -1*distance
                info["is_success"] = False
            else:
                if distance<=1:
                    reward = 10
                    info["is_success"] = True
                else:
                    reward = -40 # 超界扣大分 或 超步数
                    info["is_success"] = False
            if Done:
                info["TimeLimit.truncated"]= False # PPO等ReplayBuffer算法专属
                info["terminal_observation"]= state[i]
                reset_array[i] = True
                info["counts"] = 0

            terminated[i] = Done
            reward_array[i] = reward
        return  reward_array, terminated, truncated, reset_array

    def explain_reset(self,reset_array):
        '''给出复位位置'''
        position = {} # 复位坐标
        random_uniform: np.ndarray = np.random.uniform(size=(self.num_envs, 3))* 2 * 10 - 10
        random_uniform.astype(int)
        random_uniform[:,1] = 1
        position['sphere_robot'] = random_uniform # robot name

        angle = {} # 复位角度
        # angle['KP1'] = np.zeros(self.num_envs).fill(1.5)
        # angle['KP3'] = np.zeros(self.num_envs).fill(1.5)
        # angle['KP5'] = np.zeros(self.num_envs).fill(1.5)
        return [position, angle]
- 第三步,仔细检查你的 env ,确保 ok
conn = DHgym.connect() # 与网页连接,仅运行一次在出现 waiting for connection... 后,点击浏览器网页的 start 按钮,连接成功时 Connected 会亮,连接断开后变暗
env_Engine = DHgym_VecEnv( [lambda : myEnv(conn)]) # 查看 env
obs = env_Engine.reset()
for i in range(10):
    obs, reward,done , infomation  = env_Engine.step( np.array([env_Engine.action_space.sample(),env_Engine.action_space.sample()]))
print(obs, reward, done , infomation )- 第四步, 训练吧!stable_baselines3 功能完善,这里以它为例子。
from stable_baselines3 import  DQN
# You can train directly
env_Engine = DHgym_VecEnv( [lambda : myEnv(conn)]) # 查看 env
model = DQN("MlpPolicy", env=env_Engine,learning_rate=1e-3, verbose=1)
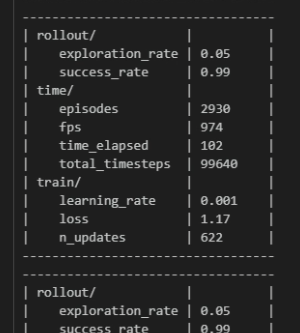
model.learn(total_timesteps=100000 ,log_interval=10,progress_bar=True)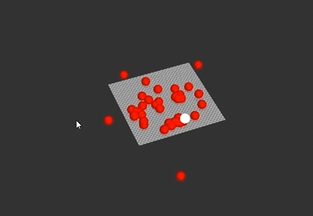
补充
该工具目前仅支持 urdf 文件(部分mjcf),且一定要保证这个文件结构清晰没有魔改
目前已实现的控制方式为:Impulse控制 和 revolute 角度控制
简易的 urdf 其实蛮好写的 ,主要由 Link 构成,如果有约束则添加 Joint
体型太小有时会导致仿真不准,尽量避免体积为0、质量为0 的不合理物体的出现
更多推荐
 5
 0
- 0


 已为社区贡献1条内容

所有评论(0)