X-SQL:基于多大型语言模型的 Text-to-SQL 专家级模式关联与理解
随着大型语言模型(LLMs)在代码生成任务中展现出卓越的涌现能力,Text-to-SQL已成为最受欢迎的下游应用之一。尽管近年来多个基于大型语言模型的Text-to-SQL框架取得了优异成果,但研究界往往忽视了数据库模式信息对生成高质量 SQL 查询的重要性。研究发现,此类模式信息在Text-to-SQL 任务中发挥着重要甚至决定性的作用。为应对这一挑战,本文提出了一种新颖的数据库模式专家系统,该系统包含两个核心组件。
首先,本文引入 X-Linking—— 一种基于大型语言模型监督微调(SFT)的方法,与现有的开源Text-to-SQL方法相比,该方法在模式关联(Schema Linking)任务上取得了更优异的结果。此外,本文创新性地提出 X-Admin 组件,该组件聚焦于模式理解(Schema Understanding),旨在弥合抽象模式信息与用户自然语言问题之间的差距。除了更好地利用模式信息进行学习外,本文还在系统内不同组件中尝试采用多大型语言模型(Multi-LLMs),以进一步提升系统性能。将这些技术整合到端到端框架 X-SQL 中后,该框架在 Spider-Dev 数据集上的执行准确率达到 84.9%,在 Spider-Test 数据集上达到 82.5%。这一出色性能使 X-SQL 成为基于开源模型的领先Text-to-SQL框架。
Text-to-SQL任务旨在将自然语言问题直接转换为 SQL 代码,随着大型语言模型的兴起,该任务受到了广泛关注。其核心价值在于,无论是专业用户还是非专业用户,都能借助该技术高效、便捷地进行 SQL 数据分析。
尽管Text-to-SQL与基础代码生成任务的目标都是生成可执行代码,但二者存在显著差异 —— Text-to-SQL 任务高度依赖数据库模式信息。若缺乏数据库模式知识,根本无法编写准确的 SQL 查询。然而,数据库的规模差异极大,从小型数据库仅包含几张表,到企业场景下的数据库可能包含数百甚至数千张表。在实际工作中,人类数据分析师往往需要花费数小时甚至数天时间检索和理解所需操作的表,之后才能开始编写 SQL 代码。这种对模式信息的依赖给基于大型语言模型的Text-to-SQL 任务带来了巨大挑战。例如,假设有一个包含 “地址(Address)”、“员工(Staff)”、“课程(Lessons)” 和 “客户(Customers)” 等候选表的数据库,用户提出问题:“名为简妮莎・萨文(Janessa Sawayn)的员工是何时加入公司的?” 要生成正确的 SQL 查询,首先必须确定所需的表。若将整个数据库模式输入大型语言模型,不仅会大幅增加推理阶段的 Token 成本,还会提高生成 SQL 查询时出现幻觉(hallucinations)和错误的概率。根据用户问题筛选相关表的挑战被称为 “模式关联”(Schema Linking)。
尽管现有的基于大型语言模型的Text-to-SQL研究工作都在一定程度上涉及模式关联,但这些研究的核心焦点多集中在基于上下文学习(in-context learning)的方法上。据本文所知,唯一采用基于训练策略的基于大型语言模型的Text-to-SQL 研究是 MAC-SQL。然而,MAC-SQL 是在一个包含模式关联、SQL 生成和调试等任务的联合任务上对大型语言模型进行微调的。因此,现有研究中尚无任何一项工作探索过专门针对模式关联的大型语言模型微调方法 —— 而这种方法本可以自然地提升大型语言模型准确选择表的能力。
为填补这一研究空白,本文引入 X-Linking—— 一种基于监督微调(SFT)的模式关联方法。该方法通过将训练重点集中在模式关联任务上,专门提升大型语言模型的表选择能力。这种针对性训练至关重要,因为大型语言模型在预训练阶段通常无法形成检索相关表的能力。此外,在推理阶段,本文采用了自一致性策略(self-consistency strategy)—— 这是大型语言模型推理中一种广泛使用的技术,具体操作是对输入进行随机打乱后再对输出结果进行聚合。
为验证 X-Linking 的有效性,本文选取了三种当前最先进(SOTA)的Text-to-SQL方法:DIN-SQL、PET-SQL 和 MAC-SQL,并仅使用开源模型对这些方法的模式关联模块性能进行了评估。研究结果表明,与现有的模式关联方法相比,X-Linking 具有显著优势,能将端到端文本到 SQL 流水线的整体准确率提升 7%。
除了检索所需表之外,本文还发现,最终Text-to-SQL输出的准确率高度依赖于对已关联表及其对应列的深度理解。在典型的数据团队中,数据工程师通常会先花时间深入理解数据库模式,因为这些模式信息通常较为抽象。例如,即使成功识别出所需的 “员工(Staff)” 表,大型语言模型仍可能难以理解需要使用哪些列(名、姓、入职日期),进而无法基于这些列直接生成 SQL 查询。本文首次识别并阐述了 SQL 表定义与用户查询之间的这种脱节问题,并将其定义为 “模式理解”(Schema Understanding)问题。为解决这一问题,本文引入了一个新颖的组件 ——X-Admin,该组件的功能类似于数据库管理员。在将提取的数据库模式输入大型语言模型以生成 SQL 查询之前,X-Admin 会先用详细的自然语言对其进行解释。实验结果表明,X-Admin 能将端到端Text-to-SQL 系统的整体性能显著提升 1.7%。
除了数据库模式带来的挑战外,Text-to-SQL领域中另一个尚未被探索的方向是多大型语言模型(Multi-LLMs)的应用。近年来的研究表明,多大型语言模型在促进复杂系统内各组件协作方面具有巨大潜力。基于此,本文认为,在文本到 SQL 系统的特定组件中采用不同的大型语言模型可能会带来益处。通过在 X-SQL 系统的各个组件上使用四种最先进的编码类和通用类大型语言模型进行实验,本文证实,基于多大型语言模型的 X-SQL 系统能够实现性能提升:与使用单一大型语言模型的系统相比,在 Spider-Dev 数据集上准确率提升 1.3%,在 Spider-Test 数据集上准确率提升 2.2%。
综上所述,本文的贡献如下:
-
提出了 X-Linking—— 一种基于监督微调的模式关联组件。该组件的性能优于三种广泛使用的Text-to-SQL框架的模式关联模块,取得了最先进的结果,准确率提升 7%。
-
识别了模式理解这一挑战,并开发了新颖的 X-Admin 组件。该组件通过用详细的自然语言解释提取的数据库内容,有效弥合了抽象模式信息与用户查询之间的差距,为 X-SQL 系统提供了增强支持。这一创新使 X-SQL 系统的性能显著提升 1.7%。
-
分析并证实了在 X-SQL 系统各组件中采用多大型语言模型的优势,最终使系统准确率提升 2.2%。仅使用开源模型的情况下,完整的 X-SQL 系统在 Spider-Dev(84.9%)和 Spider-Test(82.5%)基准测试中表现优于其他解决方案,取得了最高分数。
近年来,Text-to-SQL领域取得了显著进展,其发展历程从早期的基于规则的系统,逐步演进到复杂的、基于序列到序列(Seq2Seq)模型的类机器翻译方法。大型语言模型的出现进一步推动了Text-to-SQL 框架的发展。现有的基于大型语言模型的Text-to-SQL研究可分为以下几个方向:
基于上下文学习的方法
DIN-SQL首先将Text-to-SQL任务分解为四个模块:模式关联、任务分解、生成和自校正,并为每个模块设计了少样本(few-shot)提示和精心设计的提示词。DIN-SQL 表现出优异的性能,尤其在 Spider基准测试中的复杂问题上表现突出。然而,C3指出,由于使用了大量少样本示例,DIN-SQL 的少样本输入上下文长度往往超过 10,000 个 Token。为解决这一问题,C3 提出了一种有效的零样本(zero-shot)提示方法,该方法采用清晰的模板和用于模型偏差校准的提示,从而提升了模型性能。
此外,DAIL-SQL评估了各种提示模板的有效性,并引入了 DAIL-Selection—— 一种先进的动态少样本示例选择机制。同时,DAIL-SQL 也是首个评估开源模型在文本到 SQL 任务上性能的研究。MCS-SQL提出了一种类似于自一致性的策略,但该策略通过修改候选提示的语义结构,并采用多选(Multiple-Choice)选择机制来实现。PET-SQL对不同的提示格式进行了全面综述,并提出了一种基于生成初步 SQL 查询、再从候选 SQL 查询中筛选相关表 / 列的模式关联方法。此外,PET-SQL 还实现了一种基于多大型语言模型的交叉一致性(cross-consistency)机制。上述这些研究在使用 GPT-4等闭源模型时都取得了显著成功,但在使用开源模型时性能则相对较差。
基于训练的方法
RESDSQL为模式关联任务训练了一个交叉编码器(cross-encoder),并将 SQL 生成视为类机器翻译任务,对序列到序列模型进行了微调。CHESS通过引入先进的单元格值检索方法,并对 SQL 生成大型语言模型进行微调,在 BIRD基准测试中取得了优异结果。
基于多智能体的方法
近年来,研究人员还探索了多智能体(Multi-Agents)系统,在这类系统中,大型语言模型被分配特定角色并配备相应工具,通过协作解决Text-to-SQL 问题。MAC-SQL引入了一种多智能体策略,包含选择器(Selector)、分解器(Decomposer)和优化器(Refiner)三种智能体,并使用 GPT-4 或其自定义微调的 SQLLlama-7B 模型作为智能体的基础大型语言模型。受 MAC-SQL 的启发,SQLFixAgent将重点放在优化步骤上,通过 “橡皮鸭调试”(RubberDuck debugging)生成多个修正后的查询候选。
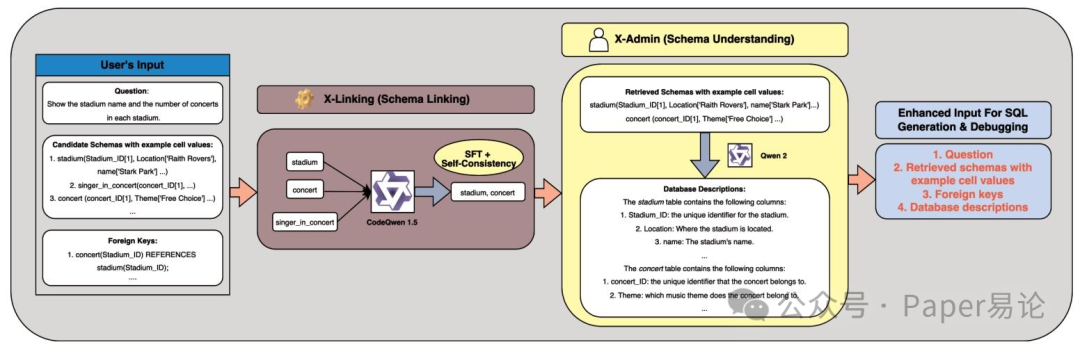
图 1:X-SQL 的架构。候选数据库模式首先经过 X-Linking(模式关联)组件筛选。之后,X-Admin(模式理解)组件为关联后的表模式添加自然语言描述。最后,利用所有这些信息生成 SQL 查询,并在查询执行出现错误时尝试对其进行修复。大型语言模型(LLMs)的设置基于 Spider-Test 基准测试中的最佳结果。
其他方法
除了基于上下文学习和多智能体的方法外,TASQL提出了一种先生成 Pandas API 函数(用符号表示替代),再将其转换为 SQL 代码的方法。该方法在使用 GPT-4 模型时也表现出优异的结果。
X-SQL 框架
如图 1 所示,X-SQL 框架包含三个组件。第一个组件是 X-Linking,它根据用户的问题识别并提取相关的数据库模式和外键信息。随后,X-Admin 组件将提取到的抽象模式信息转换为自然语言,为后续组件提供更易于理解的上下文。最后,SQL 生成与调试(SQL Generation & Debugging)组件利用 X-Linking 和 X-Admin 组件提供的信息生成 SQL 查询,并在查询执行过程中出现错误时尝试解决这些错误。在这三个组件的基础上,本文还评估了为 X-SQL 不同组件使用不同大型语言模型作为基础模型的性能,结果发现系统性能得到了显著提升。下文将对每个组件进行详细说明。
X-Linking(模式关联)
为解决现有Text-to-SQL 框架在准确率方面的局限性,并克服大型语言模型在预训练阶段无法学习模式关联的问题,本文通过专门的监督微调(SFT)训练过程实现了 X-Linking—— 一个模式关联模块。
具体而言,本文引入了一种基于 Q-LoRA的新颖监督微调方法。本文精心构建了用于模式关联监督微调训练的数据集,并将训练目标定义如下:输入由一个提示词构成,该提示词串联了数据库中的候选表模式集合 S、外键信息 K 和用户查询 Q。对于选定的大型语言模型 M,模式关联监督微调的训练目标是最大化大型语言模型 M 正确生成相应表名 T 的概率。为简化训练目标,本文将目标输出 T 构建为表名序列,而非完整的关联模式。从数学角度来看,训练过程可表示为:
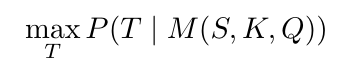
本文遵循标准的监督微调实践,通过最小化 T 与生成的表名 T' 之间的交叉熵损失进行训练。图 2 提供了测试数据示例,完整的模式关联提示词细节详见附录 A。
在推理阶段,为减轻大型语言模型的顺序偏差(Pezeshkpour 和 Hruschka,2023),本文对候选模式 S 和外键 K 的顺序进行随机打乱,生成多个输出结果。然后,将大型语言模型 M 生成的所有关联表名输出结果取并集,作为最终结果 T'。
图 1 中的模式关联组件部分展示了 X-Linking 的详细案例研究。
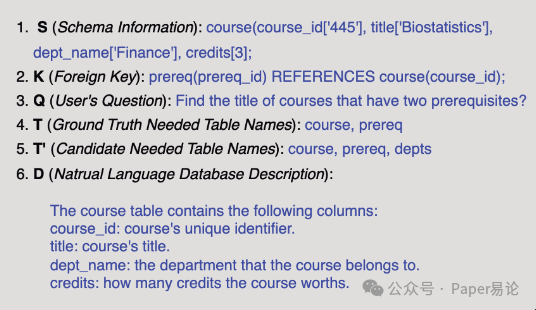
图 2:输入术语表示例
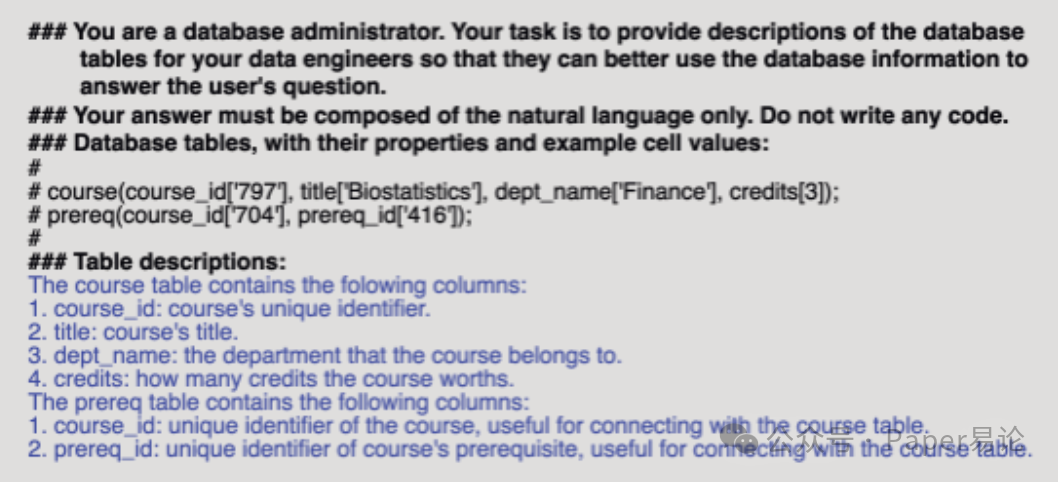
图 3:X-Admin(模式理解)提示词
X-Admin(模式理解)
X-SQL 专家级模式学习过程的第二个关键部分是 X-Admin,即模式理解组件。在筛选掉不相关的数据库表后,仍存在一个重要挑战:数据库模式定义的抽象性。如图 2 所示,数据库模式 S 与大型语言模型预训练阶段通常接触到的自然语言或编码数据存在显著差异。以往的Text-to-SQL 研究均忽视了抽象表定义与用户自然语言问题之间的这种差距。
为应对这一挑战,本文引入了一个新颖的文本到 SQL 组件 ——X-Admin,该组件也可无缝集成到所有文本到 SQL 框架中。X-Admin 通过精心设计的角色提示,为大型语言模型分配了专门的 “数据库专家” 角色。本文没有选择对模型进行微调,因为认为生成自然语言解释是大型语言模型在预训练阶段就已形成的基本能力。具体而言,针对 X-Linking 输出的关联模式,X-Admin 会根据表列的名称和样本列值,用自然语言解释每个表列的含义。此外,X-Admin 还会向后续的 SQL 生成组件提示如何利用特定列来连接不同的表。例如,如图 3 所示,抽象的列 “prereq (prereq_id)” 可被转换为更易于理解的定义:“课程先修课程的唯一标识符,可用于与课程表(course table)连接”。此类描述不仅简化了模式定义,还阐明了 “课程(course)” 表与 “先修课程(prereq)” 表之间的关系。实验表明,X-Admin 带来的收益甚至超过了调试组件 —— 而调试组件在大多数文本到 SQL 框架中被视为核心组件。X-Admin 之所以具有这种优势,是因为它与现实世界中软件工程或数据工程团队中专家的角色相契合。在实际工作中,这类人类专家通常对代码库或数据库结构有深入理解,能够详细解释每个组件及其相互之间的联系。因此,X-Admin 的专业能力可以为 X-SQL 流水线的后续阶段提供更丰富的上下文信息,弥合技术数据库结构与其实际应用之间的差距。通过整合 X-Linking 和 X-Admin 两个组件,X-SQL 系统实现了与人类专家相当的数据库理解能力,大幅缓解了大型语言模型在基于抽象数据库模式生成 SQL 查询时面临的挑战。
SQL 生成与调试
为构建完整的系统,X-SQL 还包含 SQL 生成与调试组件,这些组件遵循了以往Text-to-SQL 研究中确立的标准实践,下文将对其进行简要介绍。利用 X-Linking 输出的关联模式信息 S'、外键 K 以及 X-Admin 生成的数据库描述 D,将用户查询 Q 输入大型语言模型,生成相应的 SQL 代码。SQL 生成提示词详见附录 A。
接下来,在 SQLite 数据库上执行生成的 SQL。若执行过程未产生错误信息 E,则保留原始 SQL;若出现错误 E,则将之前使用的信息以及错误 E 重新输入大型语言模型 M,进行一轮调试。调试提示词详见附录 A。
基于多大型语言模型的Text-to-SQL 系统
除了提出的 X-Linking 和 X-Admin 组件外,本文的另一项创新是首次探索了在Text-to-SQL 系统的不同组件中应用多大型语言模型(Multi-LLMs)的影响。灵感来源于 “多元化的员工队伍能提升公司生产力” 这一观点,本文假设:文本到 SQL 系统的各个组件类似于公司中的不同角色,而不同的基础大型语言模型则代表具有不同教育和文化背景的候选人。
为全面评估多大型语言模型对端到端Text-to-SQL 性能的影响,本文在 X-SQL 系统的所有组件上,使用四种最先进的开源大型语言模型(包括通用模型和编码专用模型)进行了大量实验。结果表明,多大型语言模型方法显著提升了 X-SQL 的性能。值得注意的是,研究发现为调试组件使用不同的大型语言模型,始终能提高 X-SQL 的性能。一种可能的解释是,正如相关研究所指出的,大型语言模型往往更倾向于自身生成的内容。因此,本文假设:为Text-to-SQL 系统的不同组件使用不同的基础大型语言模型,不仅对 X-SQL 有益,还能为其他Text-to-SQL 研究工作提供帮助。
实验
实验设计如下:首先,概述用于评估模式关联模块和端到端Text-to-SQL系统的数据集、指标和模型;随后,将 X-Linking 和 X-SQL 的性能与其他主流开源方法进行对比;接着,深入分析 X-Linking 的基础模型对比结果,以及 X-Linking 与无模式关联(no Schema Linking)、理想模式关联(Oracle Schema Linking)的效果差异;最后,分析 X-SQL 系统中不同组件的贡献,以及应用多大型语言模型对系统的影响。所有实验均重复进行三次,最终结果取平均值。
在所有推理实验中,本文基于 PET-SQL提出的 SQL 定制提示词(一种包含优化规则、示例列值和外键的模板)设计提示词模板。此外,本文还对 SQL 定制提示词进行了优化,将其数据库属性(模式定义)部分与示例列值部分进行了整合。所有提示词模板的详细描述详见附录 A。
数据集
所有实验均使用 Spider 数据集—— 这是一个大规模、跨领域且广受认可的文本到 SQL 基准数据集。Spider 数据集的训练集包含 8,659 条数据,开发集包含 1,034 条数据,涵盖 200 多个数据库。此外,最新发布的测试集包含 2,147 条数据,分布在 34 个数据库中。
评估指标
模式关联
为评估根据用户问题检索相关表(即模式关联任务)的有效性,本文采用了 PET-SQL中提出的表召回率指标 Rₑ和 Rₛ。具体而言,Rₑ表示关联表名 T' 与正确表名 T 完全匹配的问题百分比;Rₛ表示正确表名 T 全部包含在关联表名 T' 中的问题百分比。在这两个指标中,数值越高表示性能越好。
端到端Text-to-SQL
为评估端到端Text-to-SQL 系统生成 SQL 查询的正确性,本文重点关注广泛使用的执行准确率(Execution Accuracy,Ex)指标。只有当生成的 SQL 查询执行结果与真值完全一致时,执行准确率 Ex 才赋值为 1。该指标至关重要,因为它直接反映了 SQL 查询执行的正确性。
对比的预训练模型
为确保对比的公平性,本文所有实验均仅使用经过指令微调的语言模型:
-
Qwen2-7B-Instruct
-
llama-3-sqlcoder-8B
-
deepseek-coder-7b-instruct-v1.5
-
CodeQwen1.5-7B-Chat
对于 X-Linking 组件的监督微调模型,本文还探索了编码器 - 解码器模型 Flan-T5-XXL(11B)的潜力,以评估序列到序列模型在模式关联任务中的可行性。
模式关联结果
本文在 Spider-Dev 和 Spider-Test 数据集上,将 X-Linking 与三种主流文本到 SQL 框架的模式关联方法进行了对比。具体而言,对比的先前研究工作包括:
-
DIN-SQL:该方法采用包含多示例的自定义提示词,引导大型语言模型检索相关表。由于原始研究使用 GPT-4,本文使用 CodeQwen1.5-7B-Instruct 复现了 DIN-SQL 的模式关联结果。
-
PET-SQL:该方法提出了一种替代的模式关联方法,即让大型语言模型生成初步 SQL,再基于该 SQL 筛选模式。本文使用 PET-SQL 中基于开源模型的最佳结果。
-
MAC-SQL:这是唯一采用基于训练的模式关联方法的研究。然而,MAC-SQL 将模式关联、调试等不同的Text-to-SQL 子任务整合到一个统一的训练目标中。
需要说明的是,尽管本文针对模式关联模型实验了多种大型语言模型,但为简洁起见,本节仅报告性能最佳的结果(使用 CodeQwen1.5-7B-Chat 实现)。关于模式关联监督微调模型所用大型语言模型的选择过程细节,详见 “X-Linking 消融研究” 部分。
表1:模式链接结果
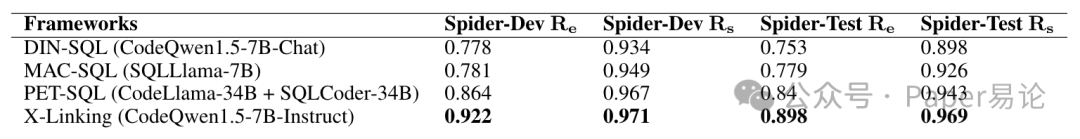
如表 1 所示,在 Spider-Dev 和 Spider-Test 数据集的 Rₑ和 Rₛ指标上,X-Linking 的性能始终优于所有现有模式关联方法。具体而言,与当前最佳结果相比,X-Linking 在 Rₑ指标上提升了 5.5%,在 Rₛ指标上提升了 2%。同时,X-Linking 的性能也显著超过了基于训练的 MAC-SQL 方法,这充分证明了本文提出的专门针对模式关联的训练方法的有效性。通过 X-Linking,不仅大幅简化了后续Text-to-SQL 组件的模式输入,还能召回更多相关表。这些改进表明,当前Text-to-SQL 框架中的模式关联模块仍有很大的提升空间。
端到端Text-to-SQL 结果
除 X-Linking 外,本文还在 Spider-Dev 和 Spider-Test 数据集上,将端到端的 X-SQL 方法与四种领先的文本到 SQL 方法进行了对比,且所有方法均仅使用开源模型作为基础大型语言模型。对比的方法包括:
-
MAC-SQL:该方法采用多智能体系统,包含选择器、分解器和优化器智能体。本文使用基于 CodeLlama-7B构建并经过多个Text-to-SQL 子任务微调的 SQLLlama-7B 模型的结果。
-
DIN-SQL:该方法引入了分解器模块,将复杂问题分解为多个步骤。由于原始 DIN-SQL 使用 GPT-4 进行评估,本文使用 CodeQwen1.5-7B-Chat 复现了其结果。
-
PET-SQL:该方法利用自定义的Text-to-SQL 提示词和多大型语言模型实现交叉一致性。本文使用其基于五个大型语言模型集成的最佳结果。
-
RESDSQL-3B + NatSQL:这是一种基于训练的方法,将交叉编码器和序列到序列模型与中间表示 NatSQL相结合。本文使用其最佳结果进行分析。
遵循简洁原则,本文展示了 X-SQL 的最佳大型语言模型配置。关于 X-SQL 多大型语言模型方法的配置细节,详见 “多大型语言模型消融研究” 部分。
表2:端到端Text-to-SQL的结果
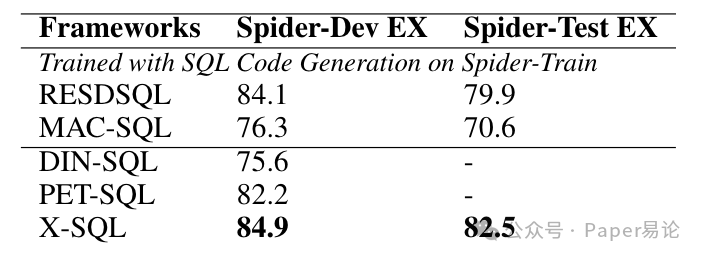
如表 2 所示,X-SQL 取得了最先进的端到端性能,优于所有现有方法。值得注意的是,在 Spider-Dev 数据集上,X-SQL 的性能比 RESDSQL(专门针对模式关联和 SQL 生成训练)高出 0.8%;在 Spider-Test 数据集上,比 MAC-SQL(同样针对模式关联和 SQL 生成训练)高出 2.6%。这些结果充分证明了本文提出的 X-Linking(专门针对模式关联的大型语言模型监督微调方法)和 X-Admin(模式理解)组件的有效性 —— 这两个组件显著提升了模型的上下文理解能力和生成准确 SQL 查询的能力。此外,X-SQL 的性能还超过了领先的基于提示词的方法 PET-SQL,提升幅度为 2.7%。有趣的是,PET-SQL 在单个组件中使用五个不同的大型语言模型进行交叉一致性推理,而 X-SQL 则通过为每个组件分配不同的基础大型语言模型来应用多大型语言模型方法。这一差异凸显了为Text-to-SQL 系统的不同组件分配专用大型语言模型的重要性。
X-Linking 消融研究
鉴于 X-Linking 组件取得的显著突破,本文进行了全面实验,以深入理解其设计选择和实现细节。
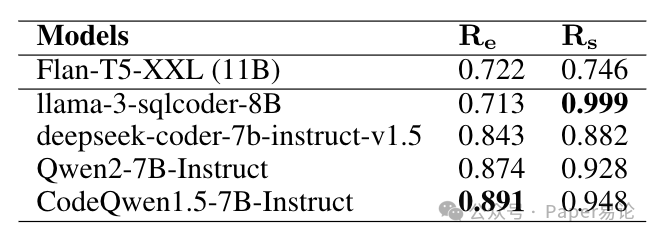
表3:Spider-Dev 数据集上的模式关联(Schema Linking)监督微调(SFT)模型
基础监督微调模型基准测试
为选择最优的基础监督微调模型,本文在模式关联监督微调任务上对五种最先进的指令微调语言模型进行了基准测试,结果如表 3 所示。监督微调(SFT)和 Q-LoRA 的超参数详细信息详见附录 B。
-
Flan-T5-XXL:尽管作为序列到序列模型,其参数规模较大,但在模式关联监督微调任务中的性能却不尽如人意(Rₑ=0.722,Rₛ=0.746)。
-
llama-3-sqlcoder-8B:该模型的 Rₛ指标看似达到了完美值(0.999),但这一结果具有误导性,因为其 Rₑ指标非常低(0.713)。若不进行任何模式关联,直接输入整个数据库模式,Rₛ指标会默认等于 1。
-
deepseek-coder-7b-instruct-v1.5 和 Qwen2-7B-Instruct:这两种模型的性能均不如 CodeQwen1.5-7B-Instruct,差距约为 3%。
因此,为在 Rₑ和 Rₛ指标之间取得平衡,本文选择 CodeQwen1.5-7B-Chat 作为模式关联监督微调任务的基础模型(Rₑ=0.891,Rₛ=0.948)。
X-Linking 与无模式关联、理想模式关联的对比
为比较 X-Linking、无增强模式关联(输入所有表)和理想模式关联(真值表)对生成 SQL 查询准确率的影响,本文将这三种关联场景作为 SQL 查询生成前的即插即用步骤,应用于四种不同的大型语言模型。
如表 4 所示,与无模式关联场景相比,X-Linking 显著提升了所有四种模型的 SQL 生成性能。同时,X-Linking 的性能也与使用理想模式关联的结果非常接近。值得注意的是,尽管 Qwen 系列模型的训练上下文长度更长,但与 llama3-sqlcoder-8B 和 deepseek-coder-7b-instruct-v1.5 模型相比,Qwen 系列模型从 X-Linking 中获得的收益更大。随着大型语言模型的训练上下文长度不断增加,本文预计,像 X-Linking 这样强大的模式关联方法在未来的大型语言模型中将会发挥更大的作用。
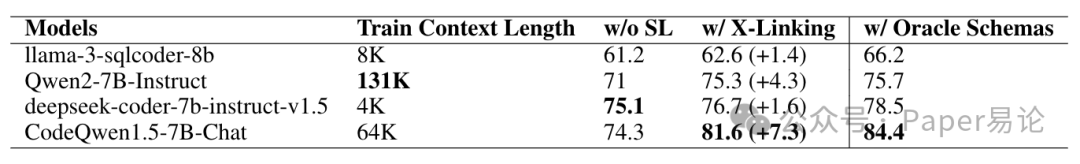
表4:X-Linking对Spider-Dev SQL生成的影响
X-SQL 消融研究
组件消融研究
为评估 X-SQL 框架中每个组件对端到端系统整体性能的贡献,本文进行了详细分析。为简化基于多大型语言模型的 X-SQL 系统的实验,鉴于表 3 和表 4 中展示的优异性能,本文在所有实验中均将 CodeQwen1.5-7B-Chat 作为 X-Linking 和 SQL 生成的基础大型语言模型。由于 X-SQL 系统中每个组件的大型语言模型组合方式繁多,表 5 展示了最优大型语言模型组合的结果。所有组件的完整大型语言模型组合设置结果详见附录 C。
-
无调试(w/o Debugging):首先,本文评估了移除调试组件(所有最先进文本到 SQL 系统中的标准组件)后 X-SQL 的性能,发现端到端系统的性能下降了 1.6%。
-
无 X-Admin(w/o X-Admin):接着,评估了移除 X-Admin 组件后的系统性能。有趣的是,性能下降幅度达到 1.7%,大于移除调试组件后的下降幅度。这一结果凸显了本文提出的 X-Admin 模式理解方法的重要性,表明其至少与公认重要的调试方法同等关键。
-
无 X-Linking(w/o X-Linking):最后,测试了移除 X-Linking 组件后的系统性能,结果显示性能显著下降 7.3%。这表明 X-Linking 是 X-SQL 系统中最关键的组件。
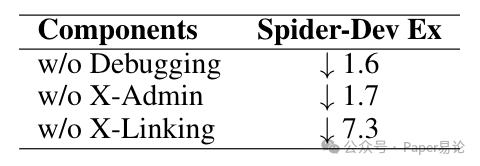
表5:X-SQL组件消融研究
多大型语言模型消融研究
为凸显本文提出的基于多大型语言模型的 X-SQL 系统相较于基于单一大型语言模型的系统的优势,本文在两种场景下对比了端到端系统的性能:(1)X-Admin 和调试组件均使用与其他组件相同的 CodeQwen1.5-7B-Chat 大型语言模型;(2)X-Admin 和 / 或调试组件使用不同的大型语言模型。由于之前已确定 CodeQwen1.5-7B-Chat 作为 X-Linking 和 SQL 生成的基础大型语言模型,因此本文重点关注 X-Admin 和调试组件的不同大型语言模型配置。受篇幅限制,表 6 仅展示了多大型语言模型系统的最佳性能结果,完整的实验结果详见附录 C。
如表 6 所示,在 Spider-Dev 和 Spider-Test 数据集上,基于多大型语言模型的 X-SQL 系统的性能始终优于基于单一大型语言模型的系统。值得注意的是,为调试组件使用不同的大型语言模型(而非同时使用 CodeQwen1.5-7B-Chat 进行 SQL 生成和调试),始终能获得更优异的性能。这一发现支持了本文之前的假设:大型语言模型可能对自身生成的输出存在偏见,而在调试组件中引入不同的大型语言模型能有效缓解这一问题。
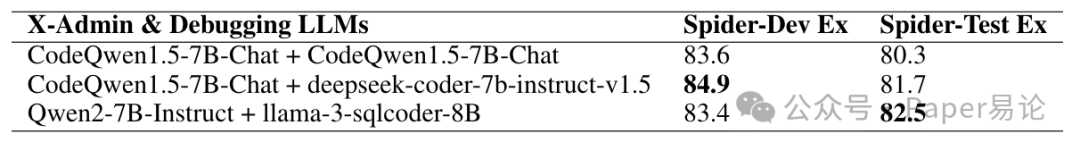
表 6:多大型语言模型(Multi-LLMs)消融研究。需注意,我们已将 CodeQwen-1.5-7B-Chat 固定为 X-Linking(模式关联)和 SQL 生成组件的基础大型语言模型(backbone LLMs)。
结论
本文提出了 X-SQL—— 一种基于多大型语言模型的专家级模式学习Text-to-SQL 框架。该框架中新颖的专家级模式学习系统包含 X-Linking 和 X-Admin 两个组件,分别使 X-SQL 的性能提升了 7.3% 和 1.7%。值得注意的是,与现有的文本到 SQL 模式关联模块相比,X-Linking 取得了最先进的结果。通过整合基于多大型语言模型的系统,X-SQL 在基于开源模型的文本到 SQL 领域树立了新的基准,在 Spider-Dev 数据集上的准确率达到 84.9%,在 Spider-Test 数据集上达到 82.5%。本文希望这项研究能为文本到 SQL 系统的进一步探索和发展提供启发,尤其是在更强的模式学习和基于多大型语言模型的系统方面。
可复现性检查清单
本文
-
包含对所引入人工智能方法的概念概述和 / 或伪代码描述:是
-
清晰区分观点、假设、推测与客观事实和结果:是
-
为不熟悉相关领域的读者提供了必要的教学参考资料,帮助其理解并复现本文工作:是
理论贡献
-
本文是否有理论贡献:否
数据集
-
本文是否依赖一个或多个数据集:是
-
已说明选择这些数据集进行实验的原因:是
-
本文引入的所有新数据集均包含在数据附录中:不适用
-
本文引入的所有新数据集将在论文发表后公开可用,并提供允许研究用途免费使用的许可:不适用
-
所有源自现有文献(可能包括作者之前发表的工作)的数据集均附有适当引用:是
-
所有源自现有文献(可能包括作者之前发表的工作)的数据集均公开可用:是
-
所有未公开可用的数据集均已详细描述,并解释了为何公开可用的替代数据集在科学上无法满足需求:不适用
实验
-
本文是否包含计算实验:是
-
数据预处理所需的所有代码均包含在附录中:否
-
进行和分析实验所需的所有源代码均包含在代码附录中:否
-
进行和分析实验所需的所有源代码将在论文发表后公开可用,并提供允许研究用途免费使用的许可:是
-
所有实现新方法的源代码均附有详细注释,注明每一步对应的论文内容:是
-
若算法依赖随机性,则已详细描述设置随机种子的方法,足以实现结果复现:否
-
本文详细说明了运行实验所用的计算基础设施(硬件和软件),包括 GPU/CPU 型号、内存大小、操作系统以及相关软件库和框架的名称与版本:部分说明
-
本文正式描述了所使用的评估指标,并解释了选择这些指标的原因:是
-
本文说明了计算每个报告结果所用的算法运行次数:是
-
实验分析不仅包含性能的单维度总结(如平均值、中位数),还包括变异程度、置信度或其他分布信息:否
-
使用适当的统计检验(如 Wilcoxon 符号秩检验)判断性能提升或下降的显著性:否
-
本文列出了论文实验中每个模型 / 算法所用的所有最终(超)参数:是
-
本文说明了开发过程中每个(超)参数尝试的数值数量和范围,以及选择最终参数设置的标准:否
附录
A. 提示词模板
X-Linking
如图 4 所示,监督微调训练和推理的输入均包含候选模式 S、外键 K 和用户查询 Q。监督微调训练和推理的具体实现如下:
监督微调(SFT)训练:给定输入,训练目标是预测关联表名 T 的真值,该真值与图 4 中 “### 所需模式名称” 这一指令后的上下文相关联。
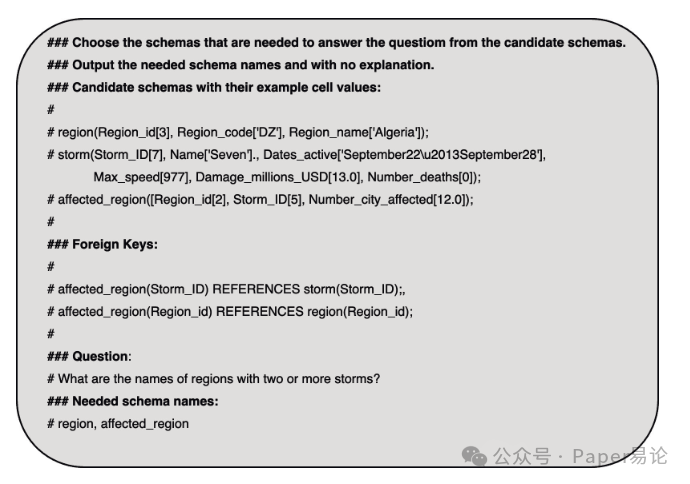
图 4:X-Linking(模式关联)提示词模板
推理阶段:为融入我们提出的增强推理策略,我们将输入的候选模式 S 和外键 K 的顺序随机打乱五次,生成五组不同的关联表名输出结果T′。最终输出对应图 4 中 “### 所需模式名称” 指令后的上下文,由这五组结果取并集得到。
SQL 生成
如图 5 所示,SQL 生成提示词会利用 X-Linking(模式关联)生成的关联模式S'、X-Admin(模式理解)提供的表描述 D、基于S'筛选得到的外键K',以及用户问题 Q,来生成候选 SQL。
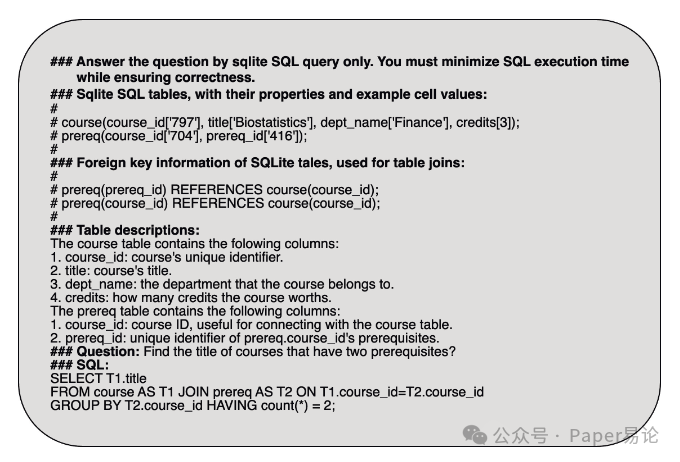
图 5:SQL 生成提示词模板
调试(阶段 / 过程)
若候选 SQL 在执行过程中产生错误 E,我们会启动调试流程。如图 6 所示,我们将该候选 SQL 连同关联模式 S'、外键 K、错误信息 E 以及数据库描述 D 一起,重新输入到大型语言模型(LLM)M 中进行调试。
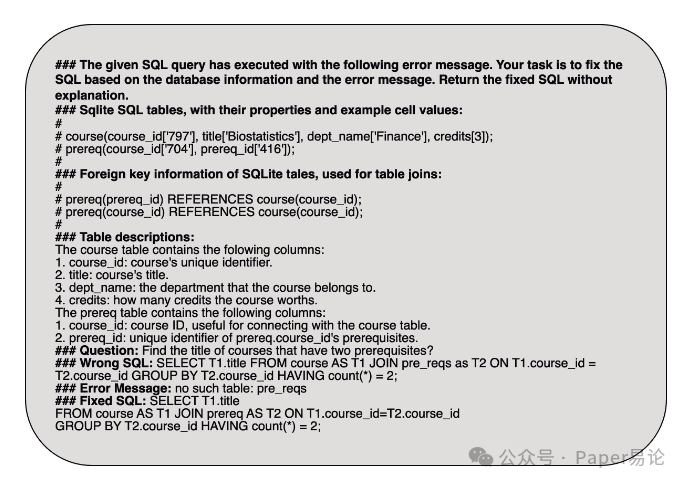
图 6:调试提示词模板
B. X-Linking 训练细节
本文使用 2 块 NVIDIA Tesla V100 GPU 对模式关联监督微调模型进行微调,采用 HuggingFace Transformers、Accelerate 和 Bitsandbytes 软件包。
通用超参数设置
本节详细说明适用于仅解码器模型(decoder-only models)和编码器 - 解码器模型(encoder-decoder model)的训练配置:
-
训练精度:fp16
-
LoRA 参数:秩(Rank)=128;阿尔法(Alpha)=256;目标模块 = Q、K、V; dropout=0.1
-
学习率调度器:恒定(constant)
-
训练批次大小:32
-
最大梯度范数:0.3
-
预热比例:0.03
仅解码器模型超参数设置
本节说明适用于仅解码器语言模型的配置:
-
学习率:1e-4
-
优化器:AdamW(Loshchilov 和 Hutter,2017)
-
训练轮次(Epoch):1
编码器 - 解码器模型超参数设置
遵循原始 Flan-T5 论文(Chung 等人,2024)中的方法,将学习率调度器调整为使用 Adafactor(Shazeer 和 Stern,2018)。此外,增加训练轮次以缓解初始训练损失不佳的问题:
-
学习率:5e-4
-
优化器:Adafactor
-
训练轮次(Epoch):3
C. 多大型语言模型实验
本节展示端到端 X-SQL 系统中整合不同大型语言模型的实验结果。在之前的 “实验” 部分中,已确定 CodeQwen1.5-7B-Chat 作为 X-Linking 和 SQL 生成组件的基础大型语言模型,因此本节重点评估 X-Admin 和调试组件使用不同大型语言模型的效果。为清晰起见,对所测试的大型语言模型使用以下缩写:
-
CQ:CodeQwen1.5-7B-Instruct
-
LS:llama-3-sqlcoder-8B
-
DC:deepseek-coder-7b-instruct-v1.5
-
QW:Qwen2-7B-Instruct
如表 6 所示,在 Spider-Dev 和 Spider-Test 数据集上,X-Admin 和 / 或调试组件使用不同大型语言模型(而非仅使用 CodeQwen-1.5-7B-Chat)时,系统取得了最优结果。这些发现充分证明了本文提出的多大型语言模型策略的有效性。
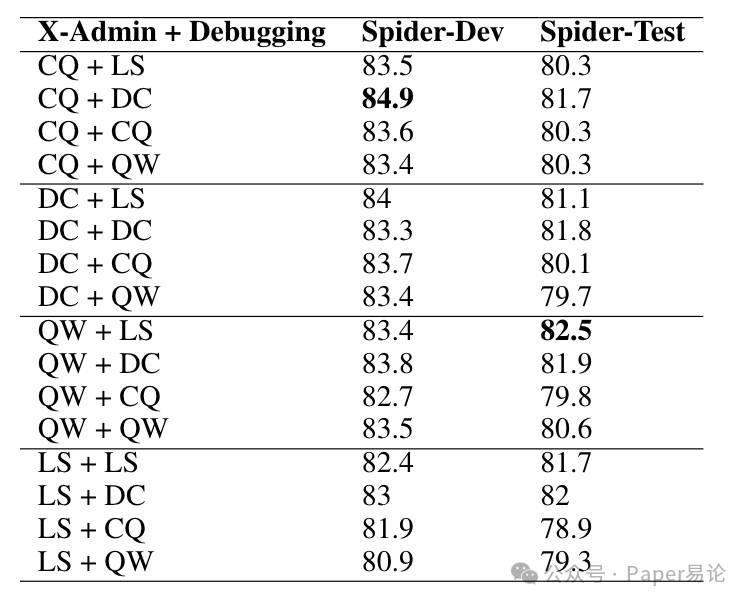
表 7:X-Admin 和调试组件所有可能基础大型语言模型组合的执行准确率
本文在主论文的 “多大型语言模型消融研究” 部分展示了最佳结果,即 CQ + DC 和 QW + LS 的结果。
D. X-Linking 监督微调的贡献
本节强调本文提出的监督微调模式关联策略在 X-Linking 组件中的重要性。如表 8 所示,本文对比了三种场景下的模式关联性能:3 样本上下文学习(3-shot ICL)、仅监督微调(SFT)以及监督微调结合增强推理(SFT + EI)。值得注意的是,监督微调方法显著提升了模式关联的有效性,使 Rₑ提升 0.565,Rₛ提升 0.614。增强推理策略进一步使 Rₑ提升 0.031,Rₛ提升 0.023。这些结果充分证明了专门针对模式关联进行训练的价值。
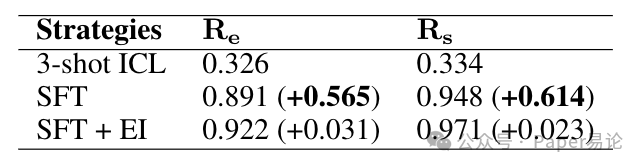
表 8:Spider-Dev 上的模式关联策略
更多推荐
 19
 0
- 0


 已为社区贡献29条内容

所有评论(0)