通用大模型发展正在逼近自身的结构性极限
阅读时间预估:约 12 分钟
(总字数约 5000 字)
⸻
过去十年,基于 Transformer 架构的大型语言模型经历了快速发展。GPT‑3、GPT‑4、Gemini、Claude 等旗舰模型在自然语言处理、多模态理解和生成式任务中取得显著进展。然而,从更长时间尺度来看,这一技术路线依赖的核心驱动力——参数规模、数据量和算力投入——正面临一系列客观约束:边际收益递减、数据瓶颈、算力与成本上限,以及模型能力外推的局限。
本文将系统梳理这些现象及其数据依据,论证通用大模型的规模化扩张正在逼近自身极限。
⸻
1 规模扩展与边际收益
1.1 早期规模定律
大模型的快速发展,得益于规模定律的发现。参数数量、训练数据量和算力的增加在早期确实带来显著性能提升。例如,OpenAI 2020 年的研究表明,在一定算力预算下,模型损失与参数量、训练数据量呈幂律下降,推动了 GPT‑3 及其同类模型的设计。
1.2 参数与数据平衡
DeepMind 的 Chinchilla 模型提出,模型性能不仅依赖于参数数量,更依赖于训练数据的规模。在算力固定的情况下,过大模型但数据不足反而效率低下。Chinchilla 使用约 70B 参数和 1.4T token 数据,表现超过同等算力下的 280B 参数模型。这表明规模扩展需要与数据同步,否则收益有限。
1.3 边际收益递减
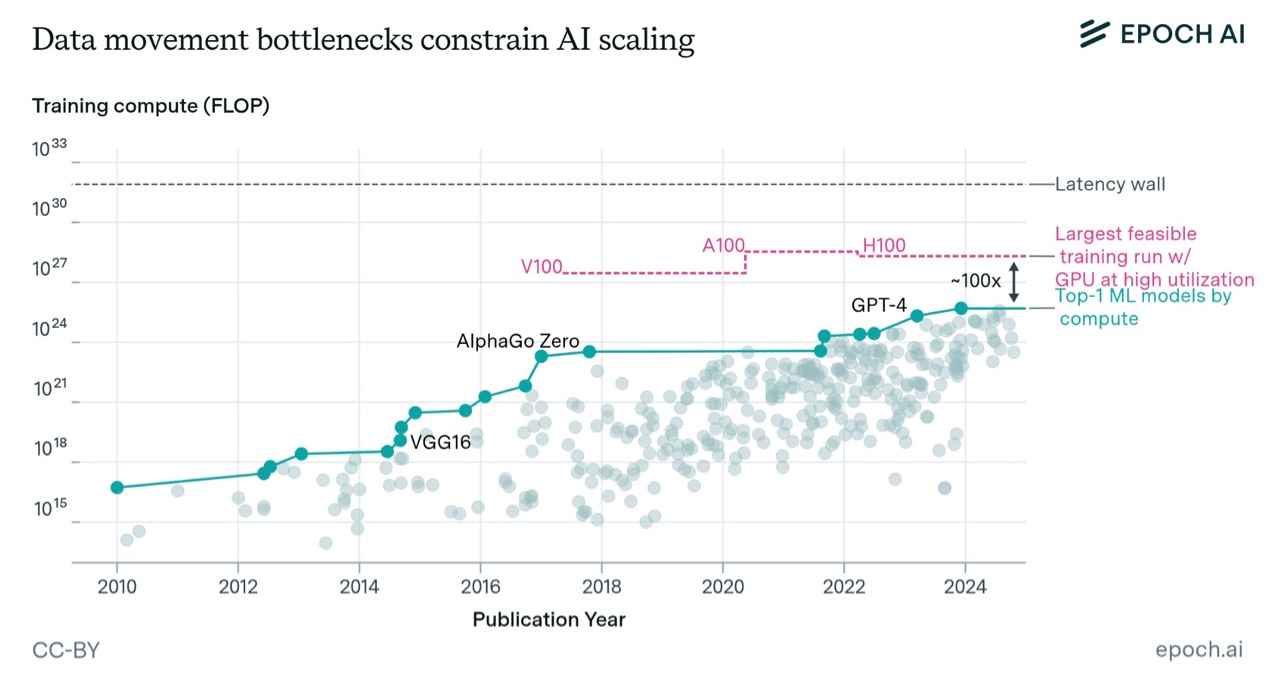
从数据来看,参数扩展带来的损失下降呈递减趋势:参数增加十倍,损失仅下降约 17%;数据增加十倍,损失下降约 25%。随着规模增长,性能提升的增量越来越小,显示出明显的边际递减效应。
⸻
2 数据瓶颈与语料限制
2.1 可用语料有限
高质量自然语言数据不是无限的。随着模型规模增长,对低噪声语料的需求也快速增加,但互联网内容质量整体下降,开源数据重复率高,获取成本上升。重复或低质量数据的训练效果有限,无法提供新的统计信息,限制了进一步提升。
2.2 合成数据的局限
使用 AI 生成数据进行自我训练在理论上可以扩充语料,但实践中会产生“信息回声”问题:模型生成的数据只是对已有模式的重复,而非真正新信息。长期依赖合成数据可能导致模型性能停滞或退化。
⸻
3 算力与成本约束
3.1 训练成本高昂
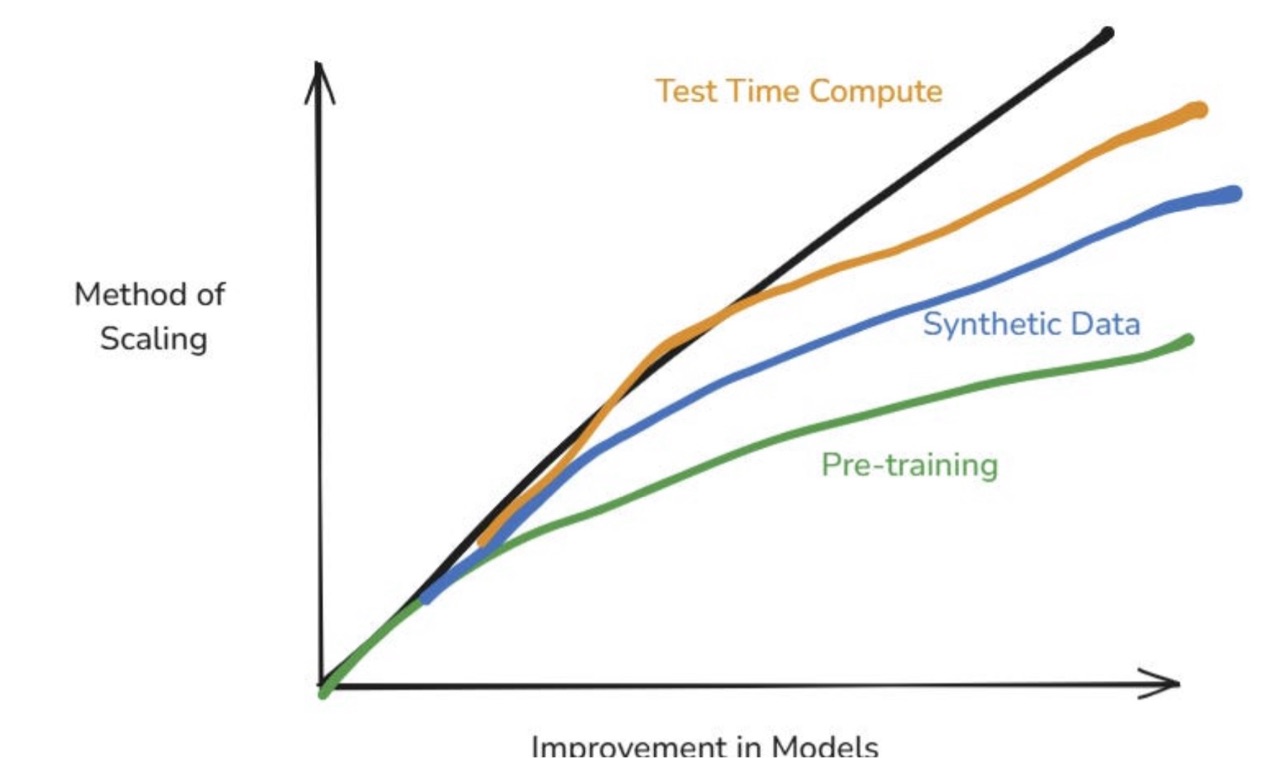
训练大模型成本随规模迅速上升。2017 年 Transformer 训练成本约为数千美元,2019 年 RoBERTa Large 约 16 万美元,2023 年 GPT‑4 和 Gemini Ultra 训练成本估计为数千万美元至上亿美元。未来更大模型的训练成本可能进一步超过 10 亿美元。
3.2 物理与供应链限制
大模型训练依赖大量高端 GPU、TPU 以及高速互联网络和冷却设施。算力增长带来电力、热量管理及供应链压力,形成不可突破的物理与经济瓶颈。
⸻
4 模型能力与外推局限
4.1 分布内与分布外
大模型在训练分布内表现优异,但在分布外任务、因果推理和长期规划上表现不稳定。它们依赖统计模式匹配而非真实世界模型,对复杂情境的泛化能力有限。
4.2 提示工程依赖
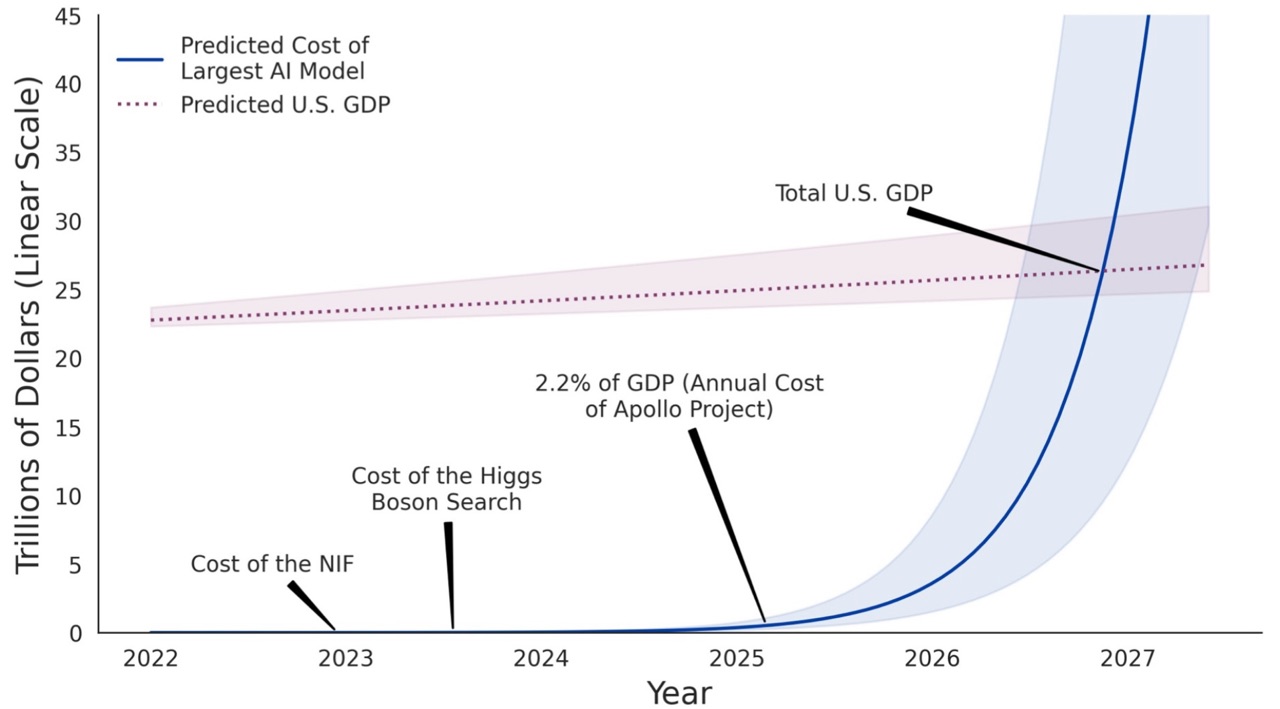
当前性能提升在很大程度依赖提示工程,如 Chain-of-Thought 等方法强化逻辑输出。虽然看似提升了推理能力,但本质上仍依赖外部框架,而非模型自身获得了新的认知能力。
⸻
5 替代技术路线
近年来,行业探索减少对大规模预训练依赖的策略,如推理计算优化和混合专家模型(Mixture-of-Experts, MoE)。这些方法通过动态激活子模型或计算步骤,实现性能提升,同时降低算力消耗,表明大模型规模扩展不再是唯一选择。
⸻
6 行业集中化与创新风险
由于训练成本高昂,少数科技巨头掌握大部分基础设施与高端算力,创新主体高度集中。这一格局限制了多样化探索,使中小机构在前沿突破上困难重重,进一步强化了规模路线的集中化趋势。
⸻
7 结论
回顾过去十年的发展,通用大模型推动了认知边界,但核心驱动因素的效用正在下降。规模扩展带来的性能提升递减,数据高质量资源有限,算力和成本约束逐步凸显,模型能力外推能力有限。
因此,仅靠参数堆叠推动智能跃迁的路线正在收敛。未来突破更可能来自新的架构、认知模型和数据利用方式,而非更大规模的模型。通用大模型仍是强大工具,但它的路线正在逐渐明确:规模扩展已不是通向更高智能的核心手段,而是工程边界正在耗尽的路径。
更多推荐
 33
 0
- 0


 已为社区贡献1条内容

所有评论(0)