知识蒸馏(一)
知识蒸馏(一)
参考:同济子豪兄的知识蒸馏论文精讲
深度学习中的知识蒸馏技术(上) - 知乎 (zhihu.com)
[论文笔记] 知识蒸馏:Knowledge Distilling - 知乎 (zhihu.com)
通俗易懂的知识蒸馏 Knowledge Distillation(上)——理论分析 - 知乎 (zhihu.com)
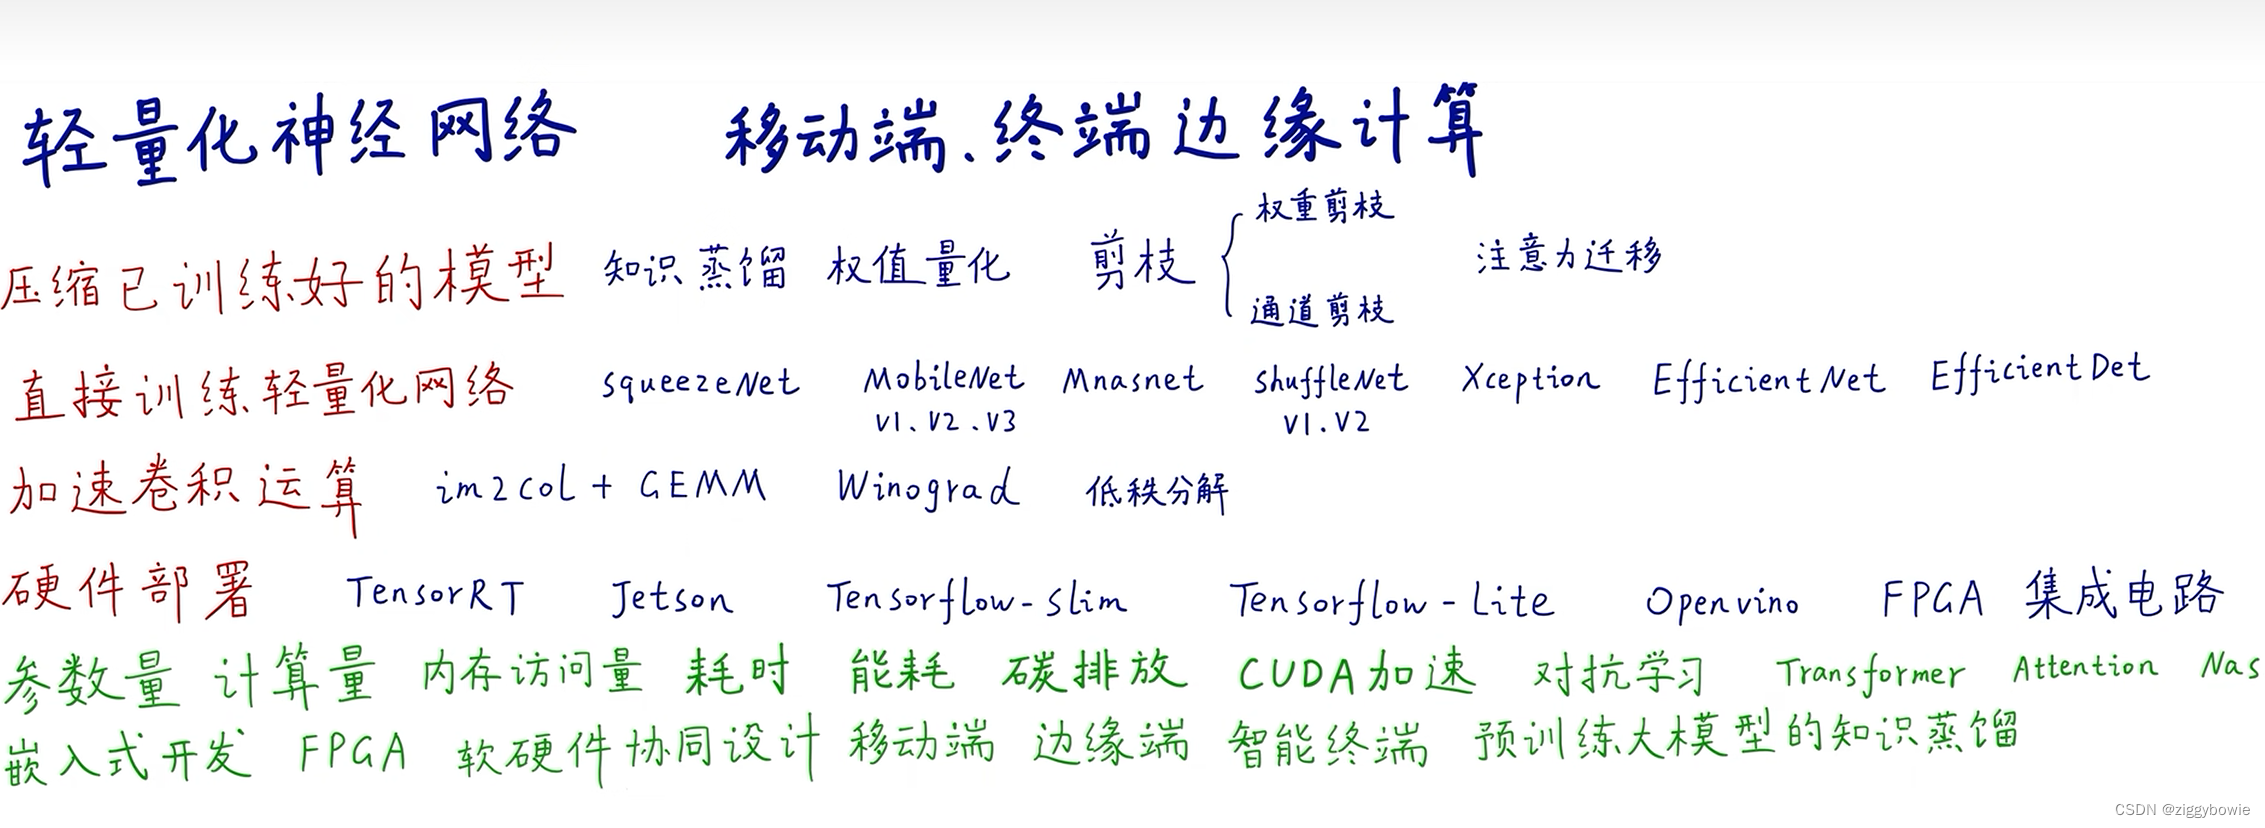
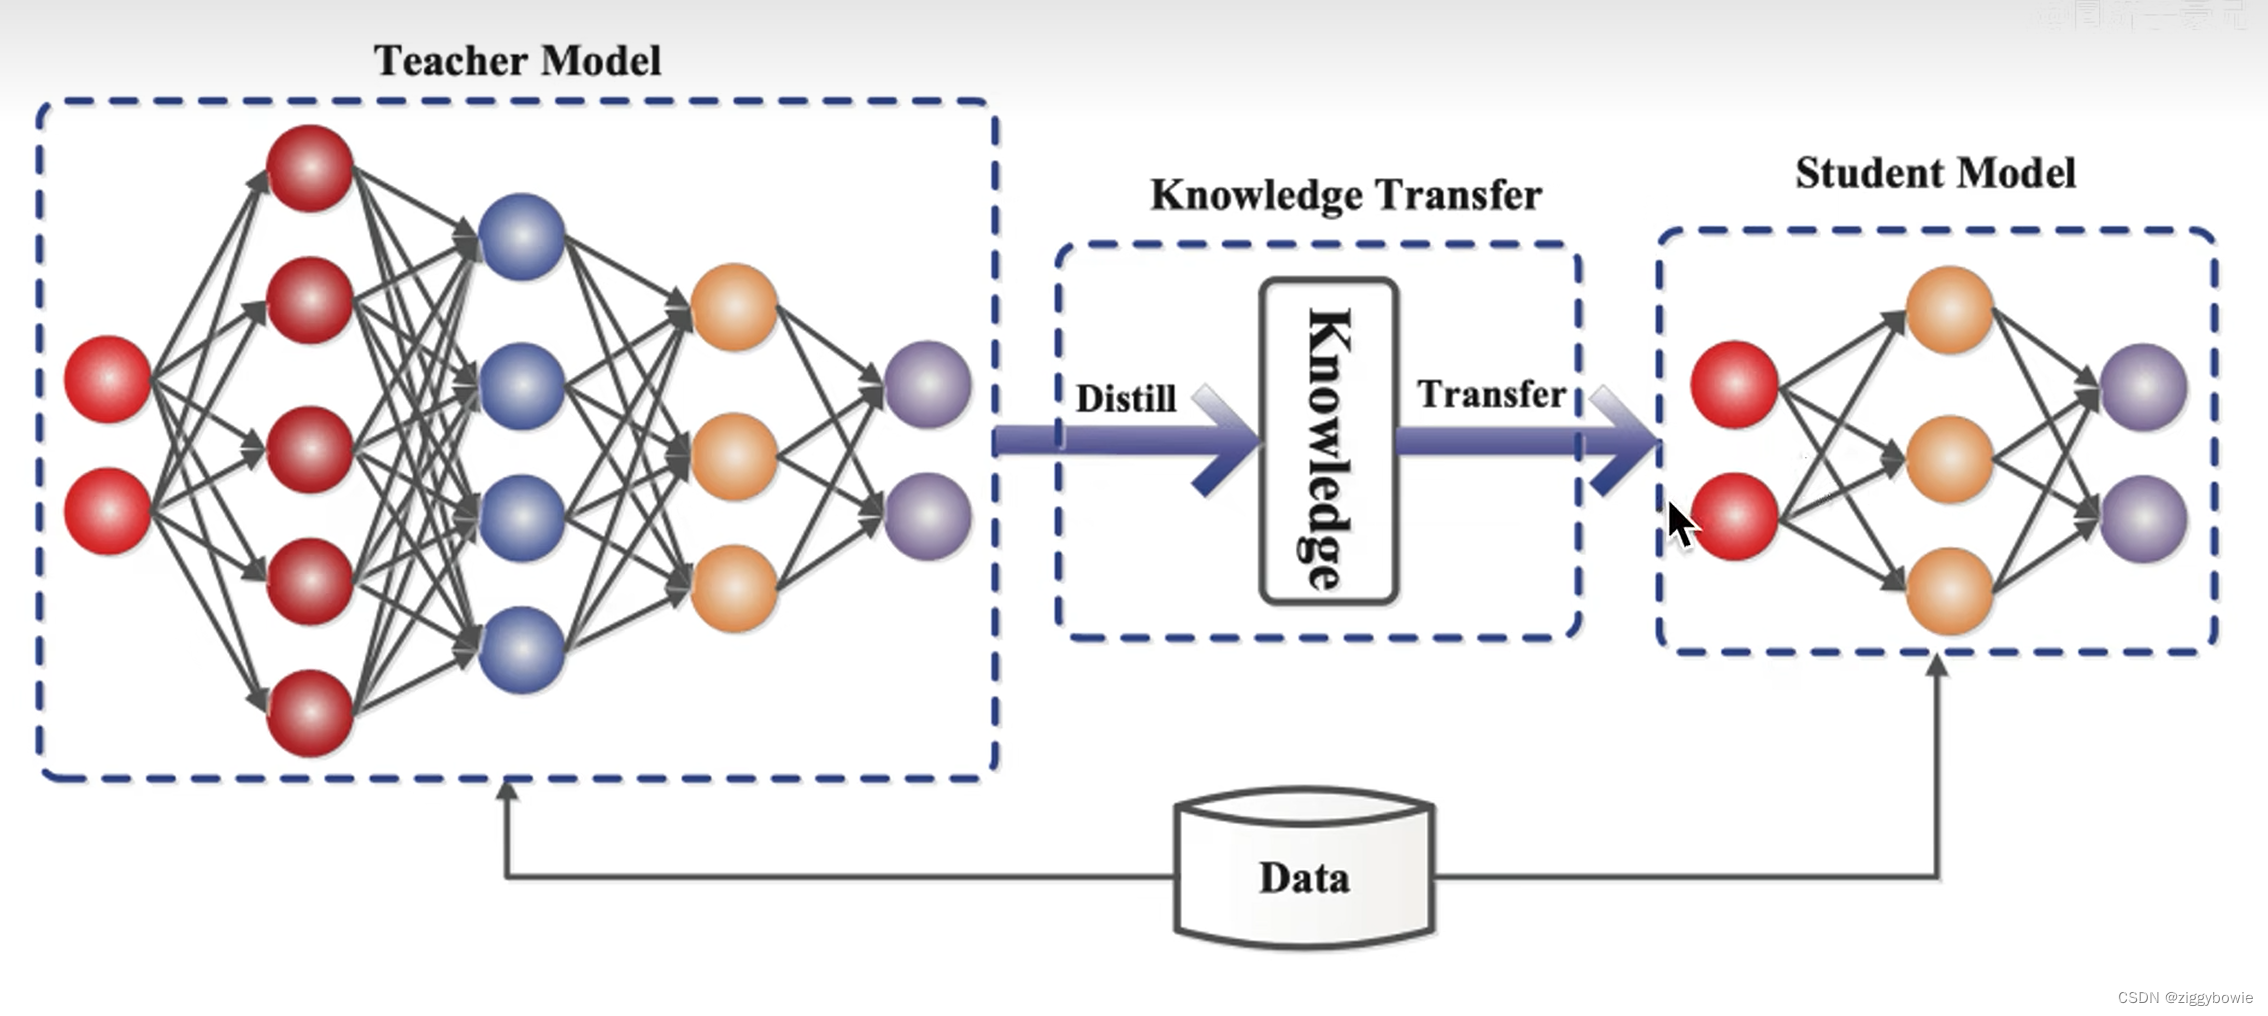
知识蒸馏是一种模型压缩技术,通过将大型、复杂的教师模型(Teacher Model)的知识迁移到小型、高效的学生模型(Student Model)中,旨在保持学生模型在较小规模下具有与教师模型相近的性能。
简介
论文标题:Distilling the Knowledge in a Neural Network
论文提出了一种新的模型压缩方法,在手写字识别(MNIST)数据集上取得了很好的效果
可以通过将模型集合中的知识提炼成一个单一模型
引入了一种新型的集合类型,由一个或多个完整模型和许多专家模型组成,这些专家模型学会了区分完整模型混淆的细粒度类别。与专家混合模型不同,这些专家模型可以快速并行训练。
问题:大规模模型训练需要大数据集大算力
但是在推理和部署时又要顾及到下游的小算力的设备
大模型获得的知识可以转移到单个小型模型中。
知识的表示和迁移
知识的表示:文中指出我们倾向于将训练模型的知识和模型的参数,权重相联系
更抽象的观点:认为知识是输入输出向量的学习到的映射,而不是特定参数值的集合。这意味着知识可以被视为模型学习到的输入输出关系,而不仅仅是参数的值。
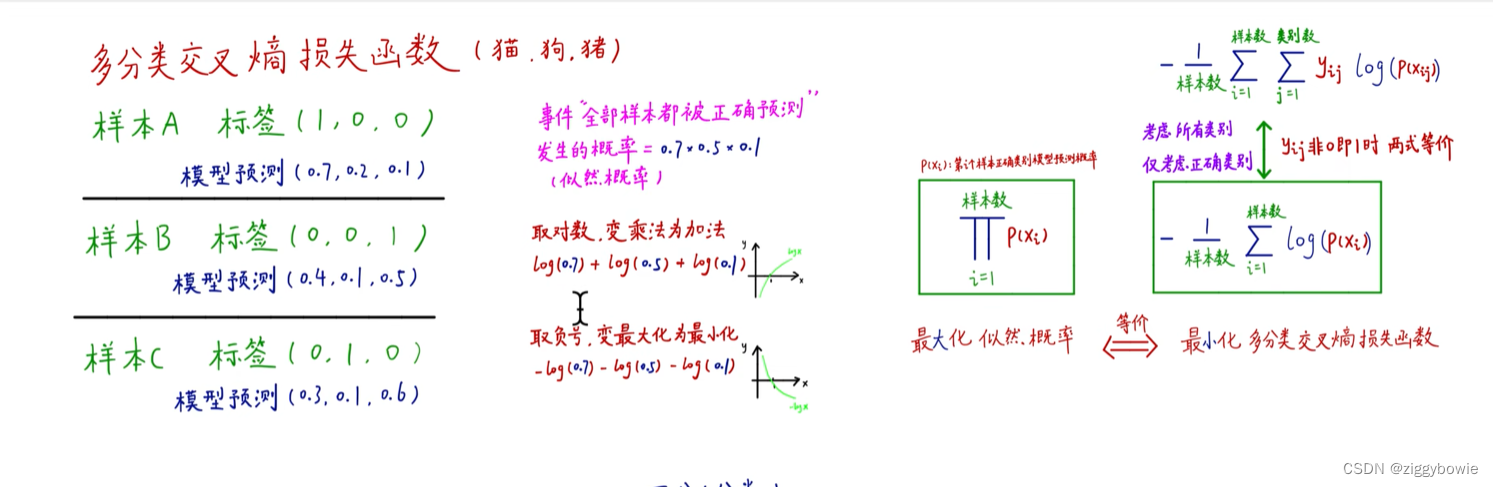
复杂模型的常见训练目标是最大化正确类别的平均对数概率(average log probability)
迁移:改变模型的形式但是保持相同的知识
teacher model,student model
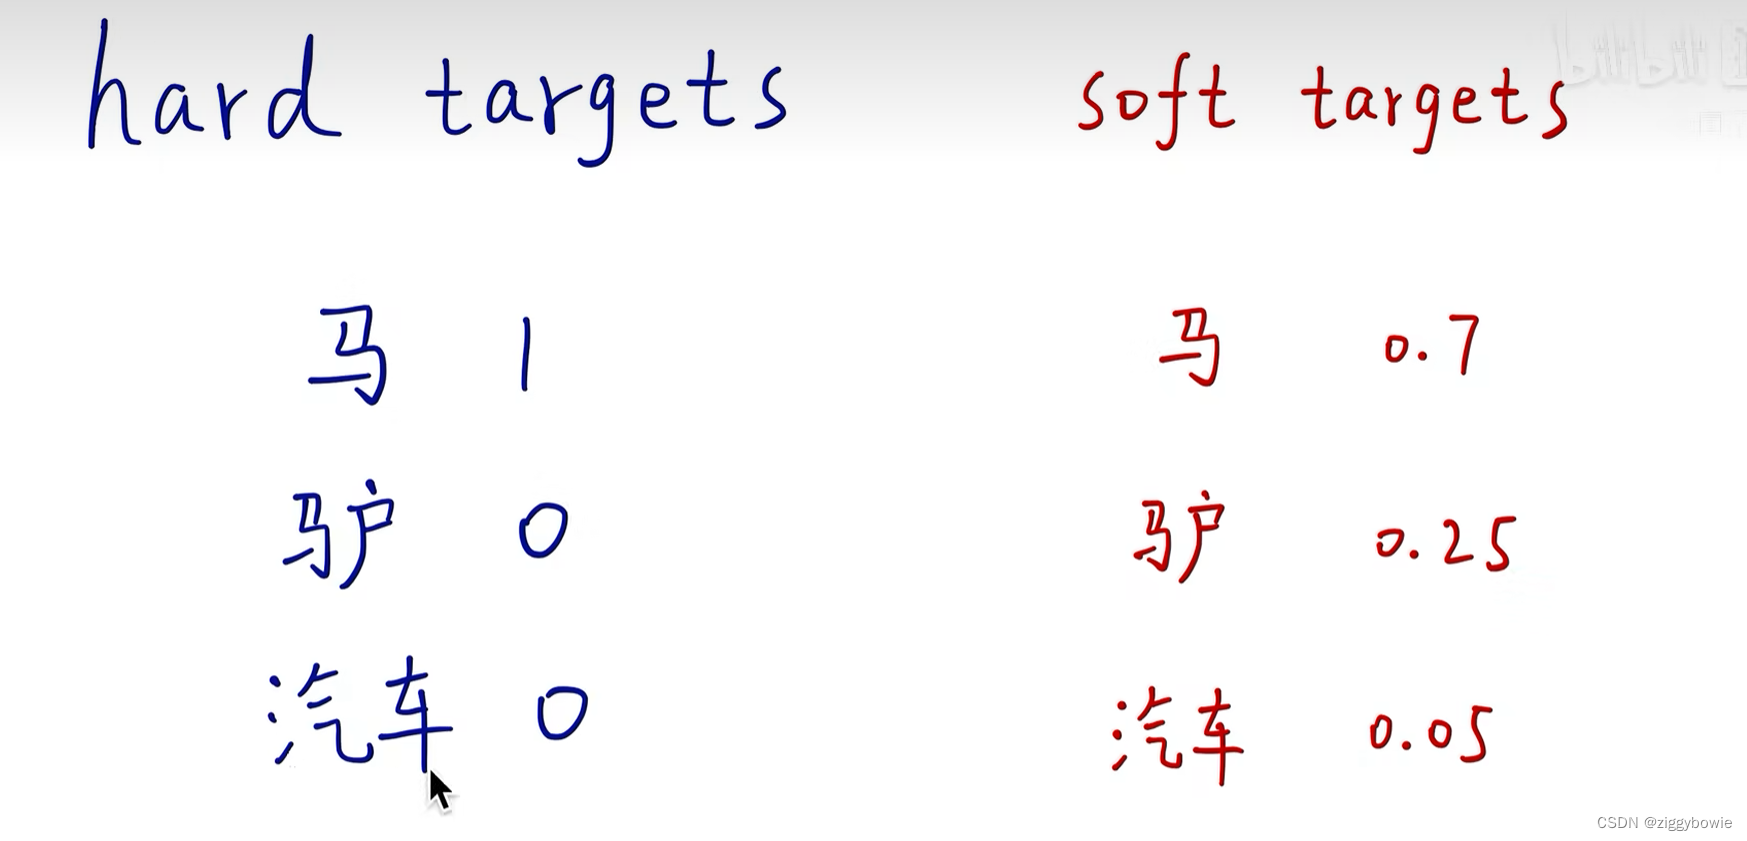
比如上图,如果我们使用hard targets,告诉了模型图片不是驴和汽车的概率是相等的(不合理)
soft targets可以看作一个分类模型的概率分布输出
训练教师网络的时候使用ht,训练学生网络时使用st(t model训练出的结果作为标签)
label smoothing
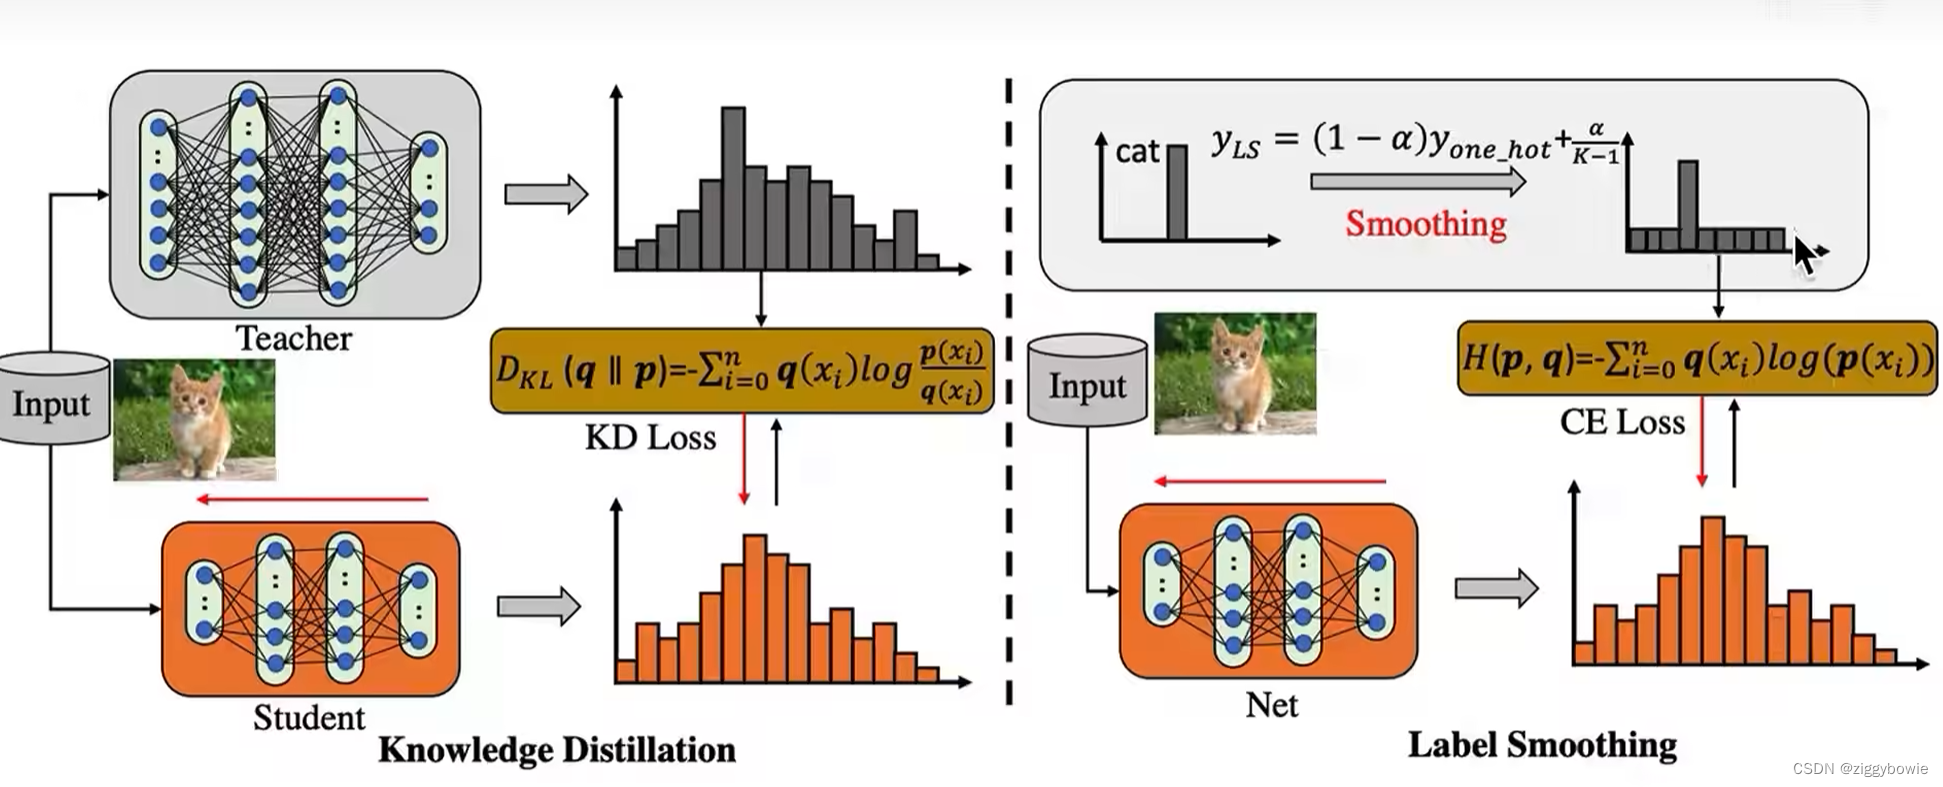
蒸馏温度T
soft"通常指的是用于训练的目标概率分布具有较高的熵,即各个类别的概率差别较小,更加平滑。相比之下,硬目标是指只有一个类别具有 1 的概率,其他类别的概率为 0,这种情况下的分布熵较低。
改造softmax
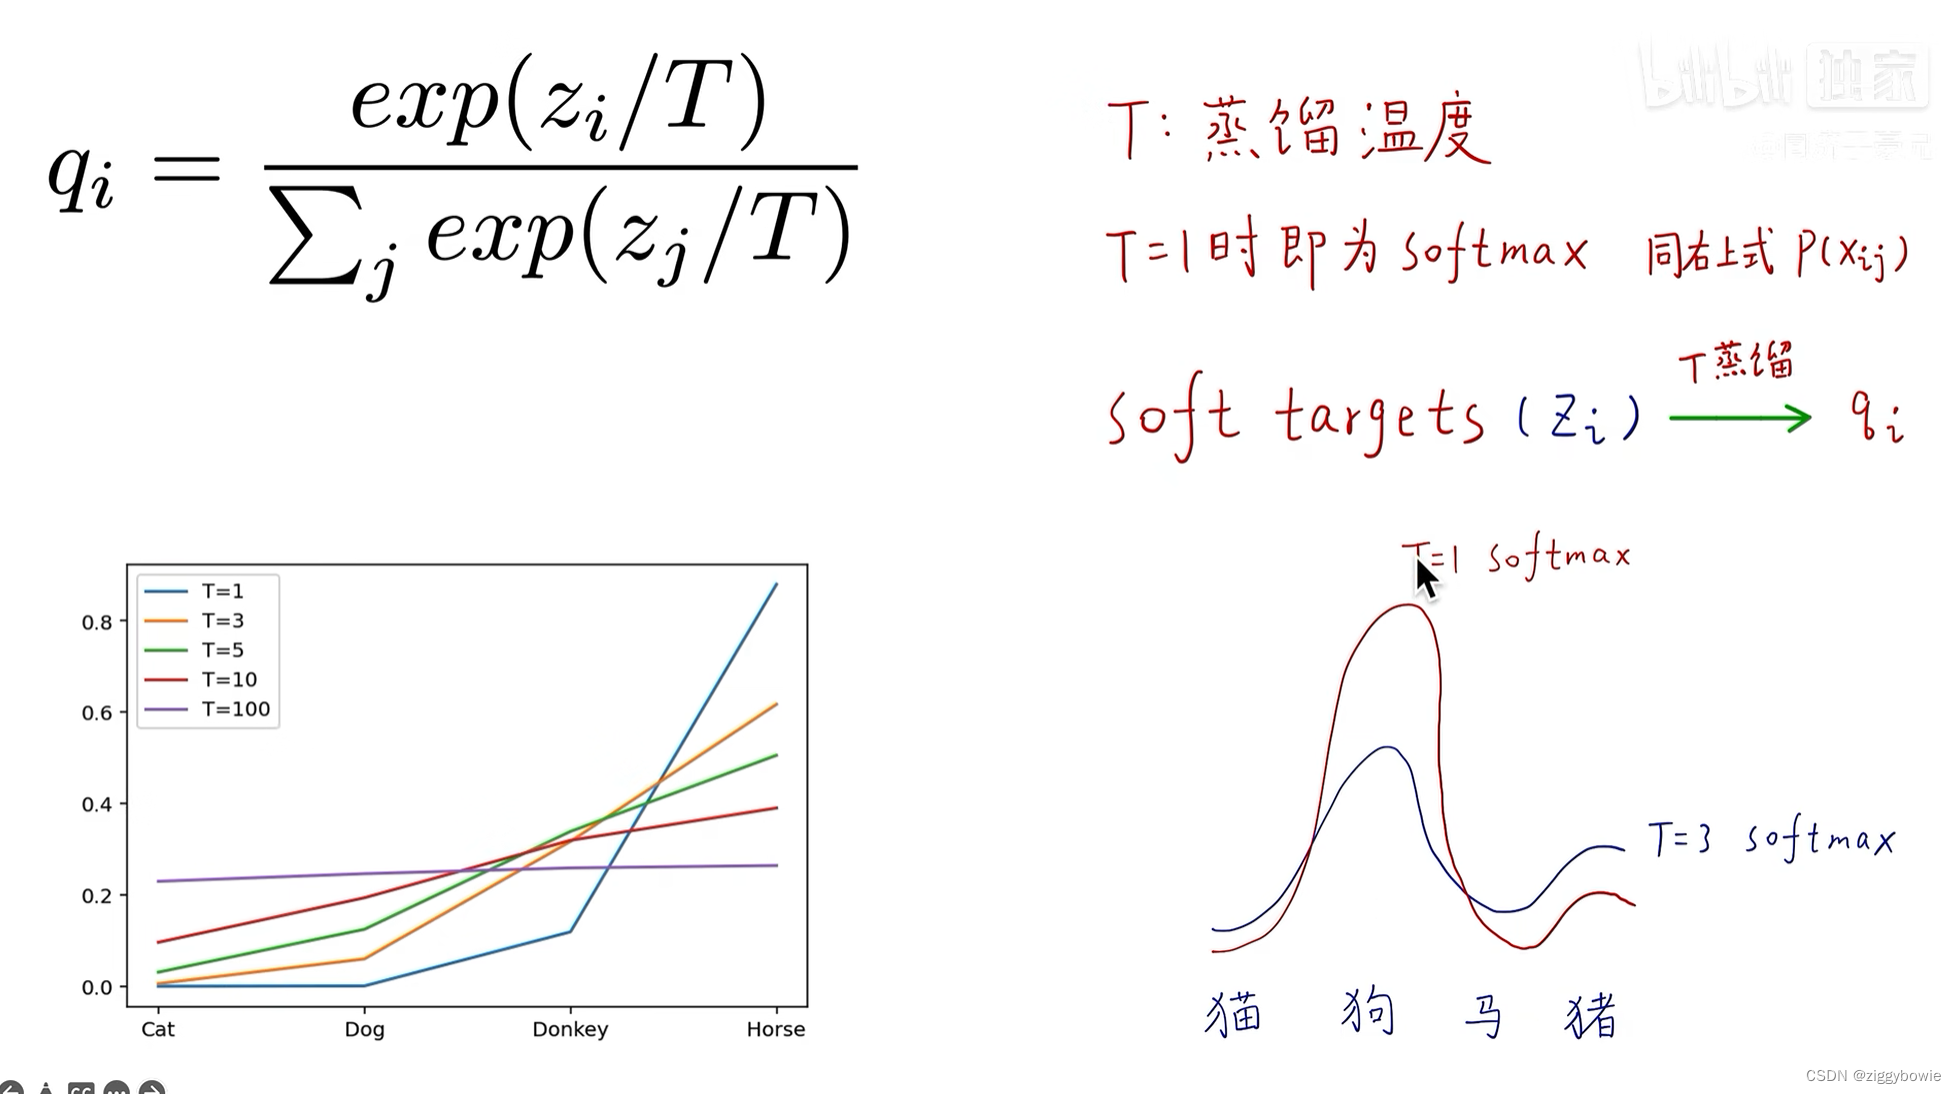
T越大越不soft
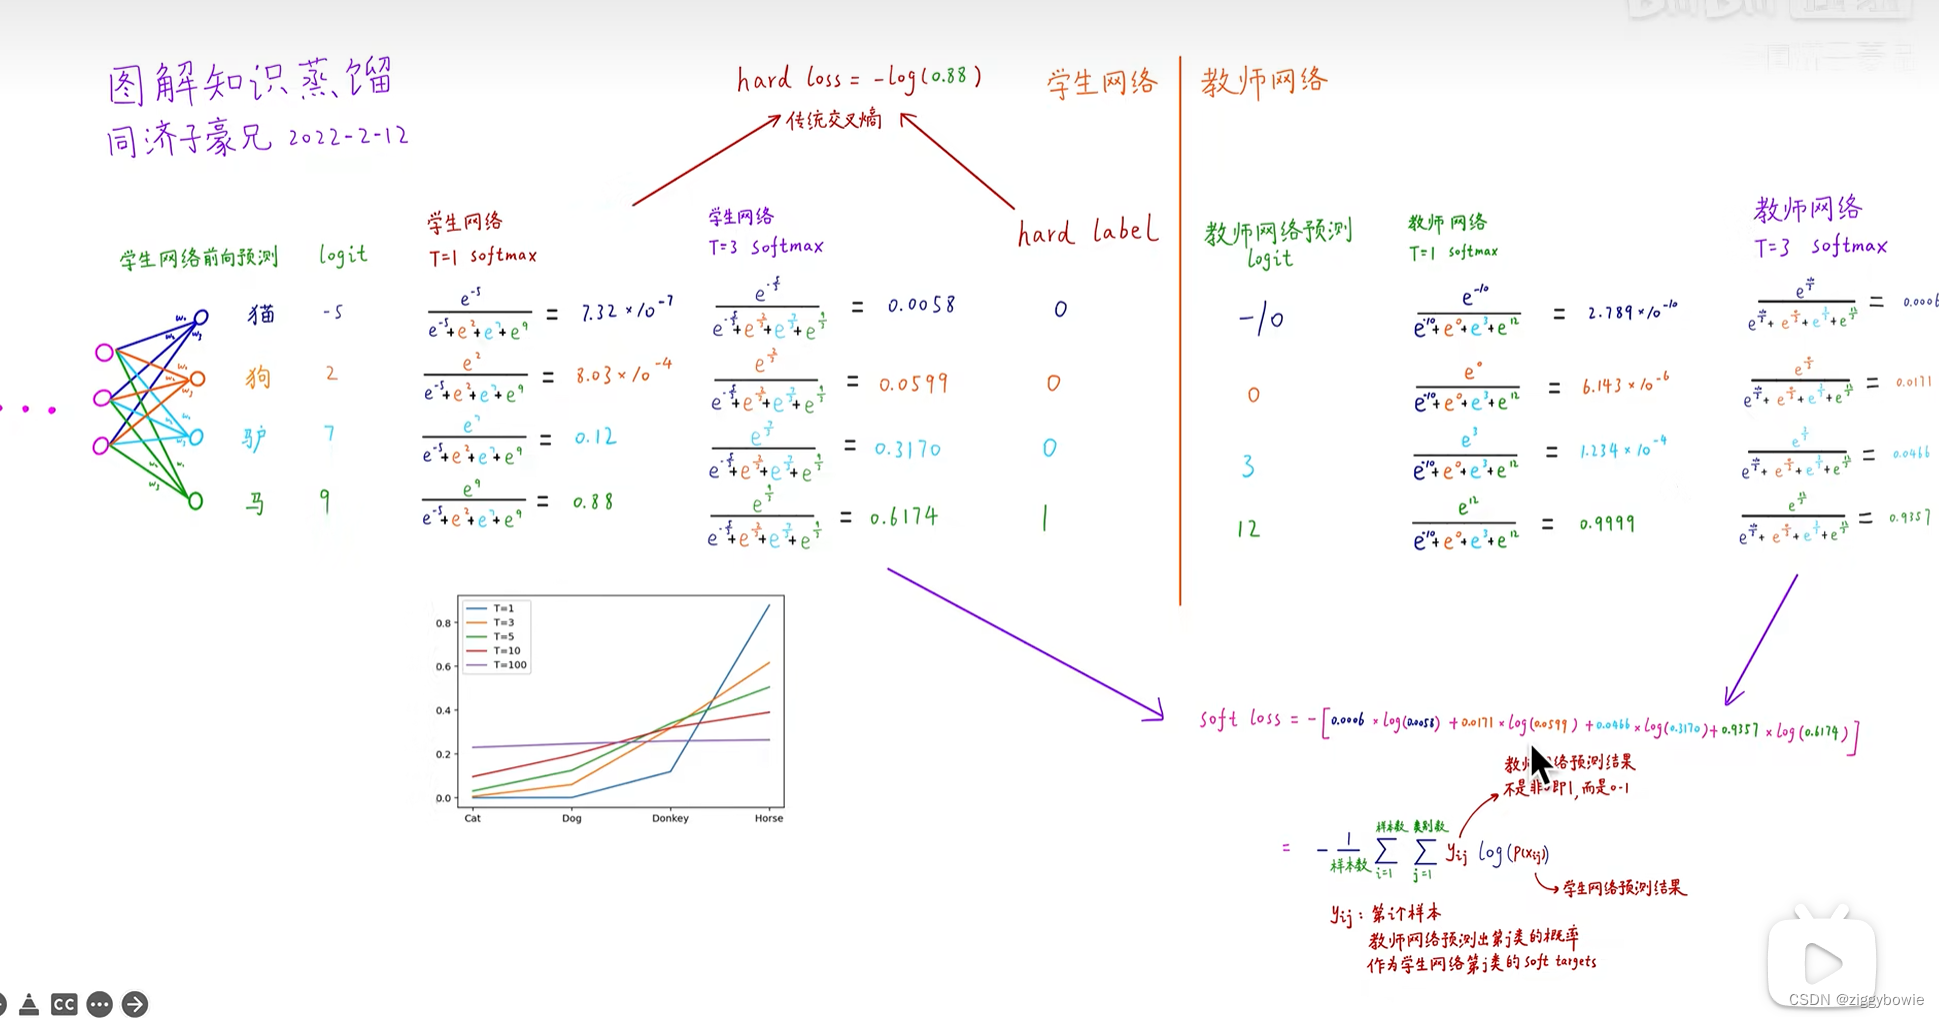
yij不再是非0即1
训练,参数学习的副产物:对错误答案也分配了概率,错误答案的相对概率提供了关于模型泛化能力的重要信息。即使模型做出了错误的预测,它们之间的相对概率也能告诉我们哪些错误更容易发生,这有助于我们更好地理解模型的行为。
将大模型的知识融入小模型,可以训练小型模型以与大型模型相同的方式进行泛化**(distillation)将大型模型中的知识传递给小型模型**
训练以与大型模型相同方式泛化的小型模型通常会比在相同训练集上以正常方式训练的小型模型在测试数据上表现更好,得到与大规模模型相同的泛化能力和表现
知识蒸馏过程
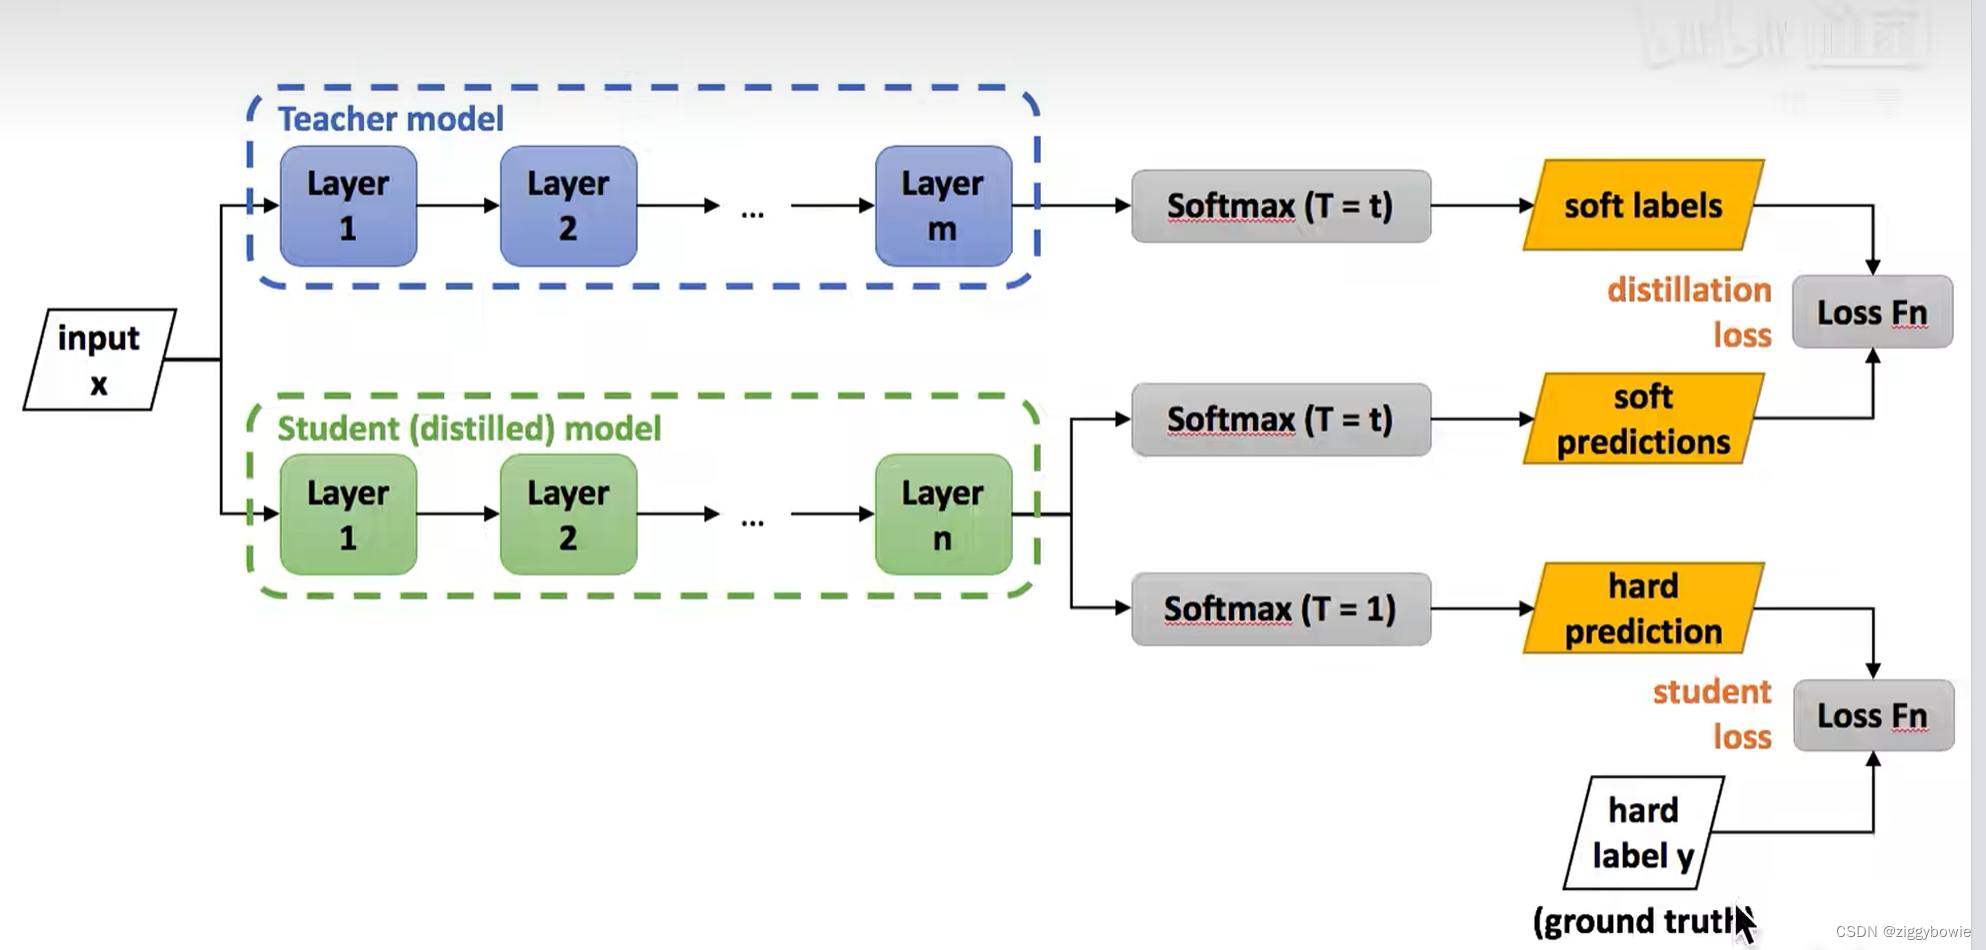
训练教师网络,训练学生网络,学生网络的训练预测要和教师网络接近,也要和标准答案接近
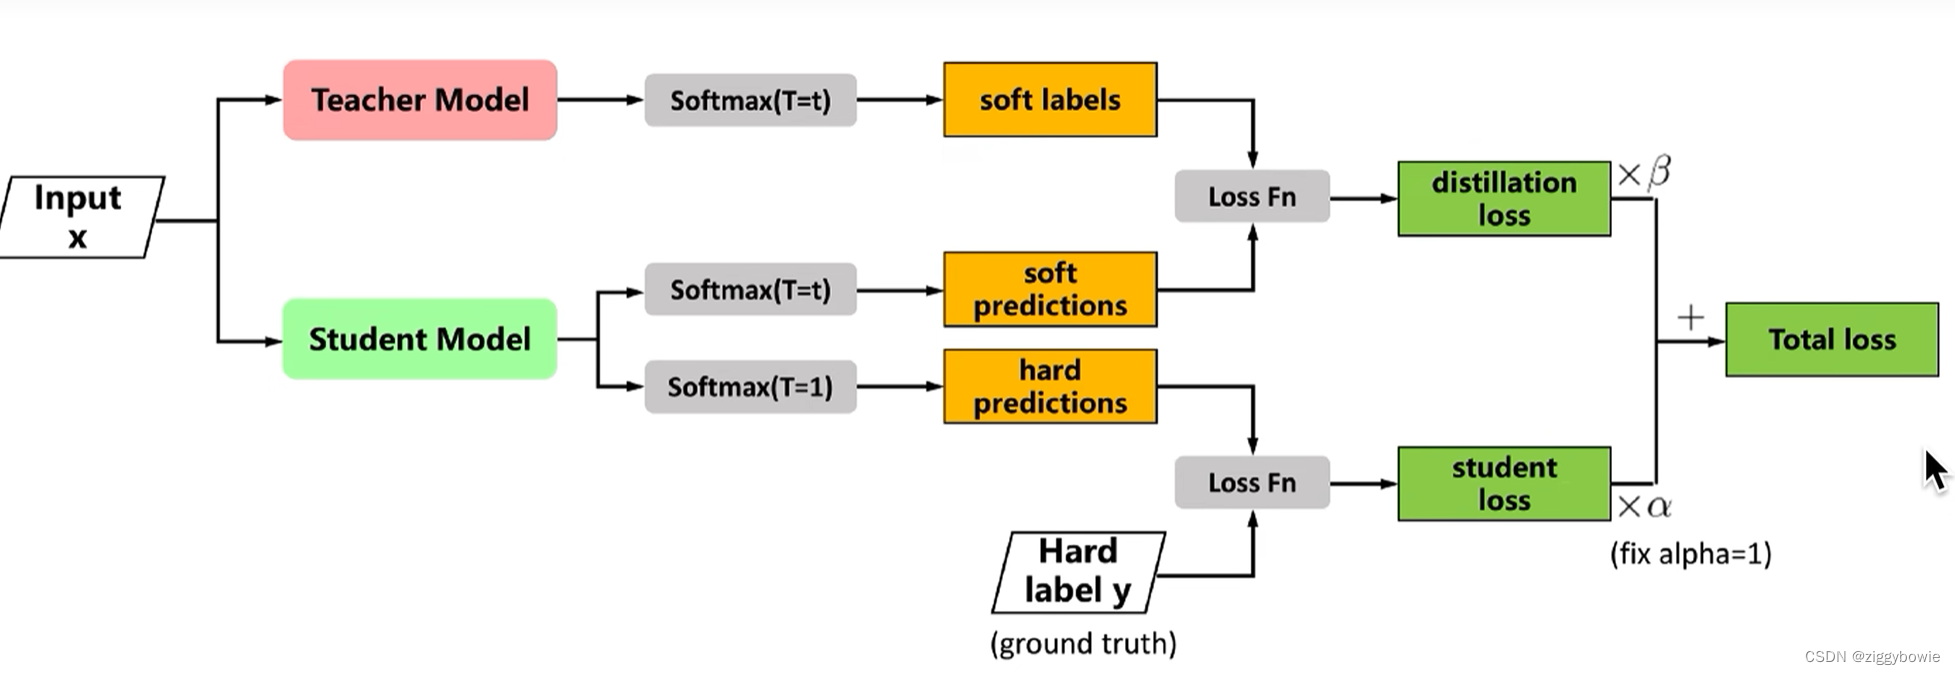
使得total loss最小
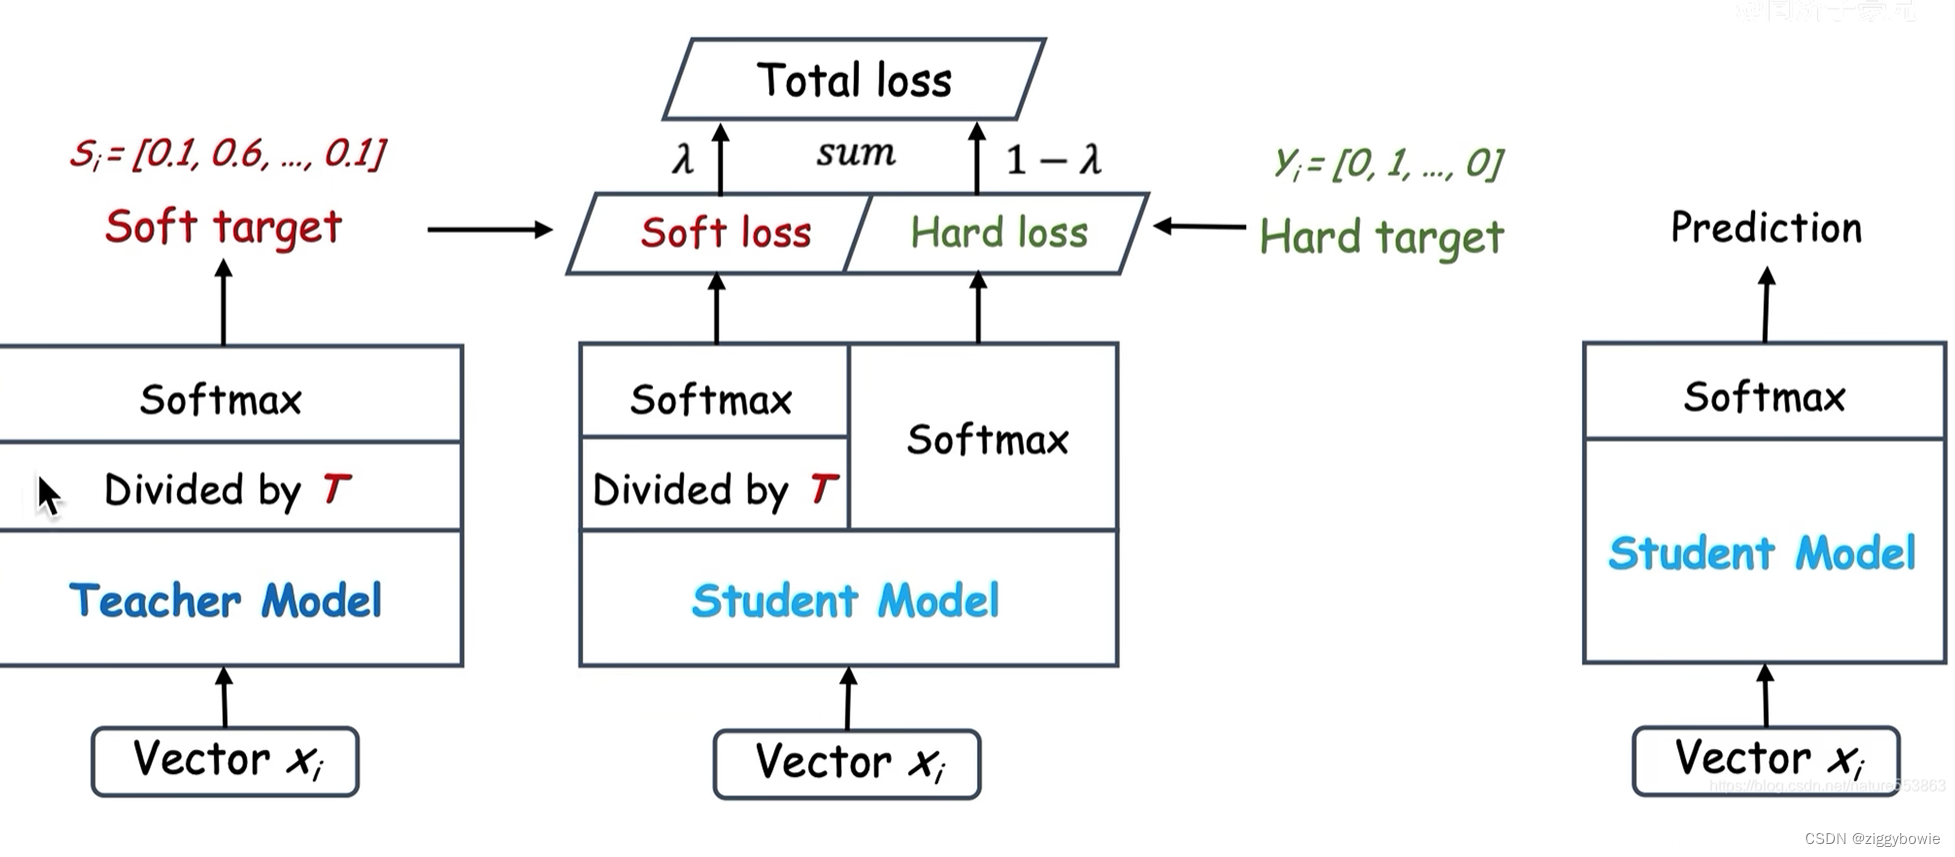
副产物:少样本或零样本学习,因为教师网络学习到了训练学生模型时缺失的类别和其他类别的关系
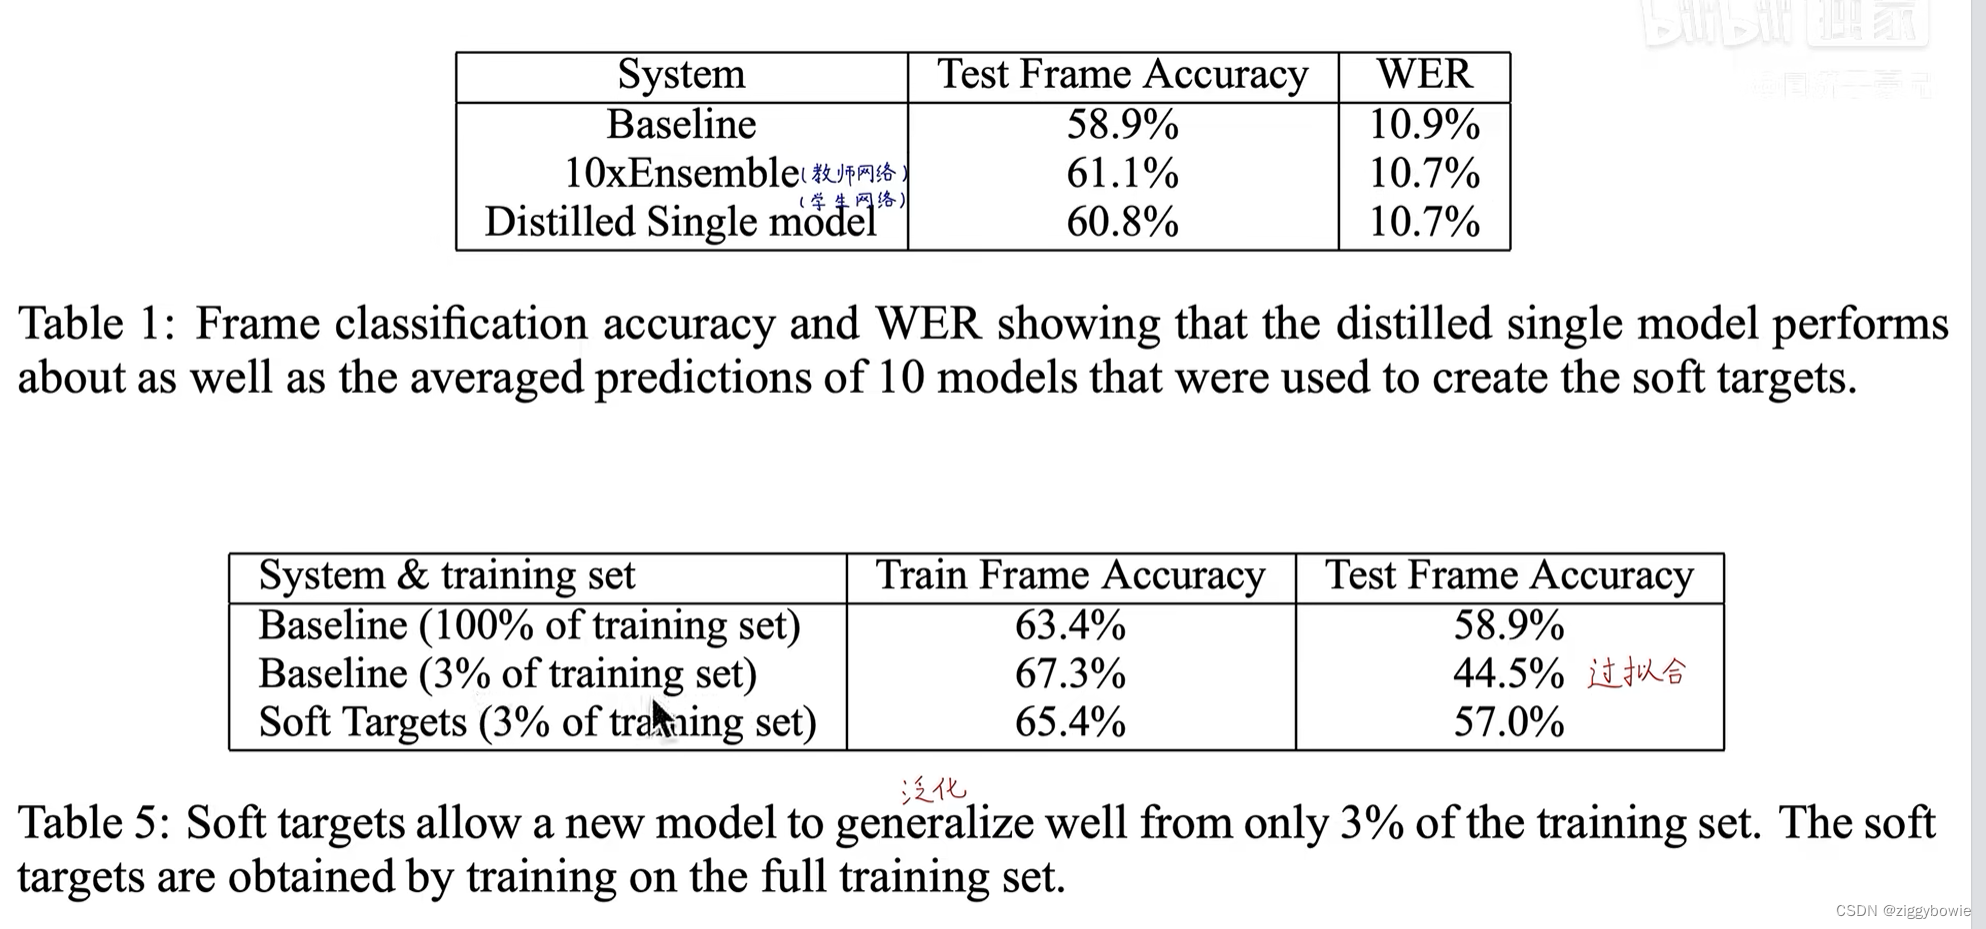
模型压缩
优化训练,防止过拟合 (潜在的正则化)
·无限大、无监督数据集的数据挖掘
少样本、零样本学习
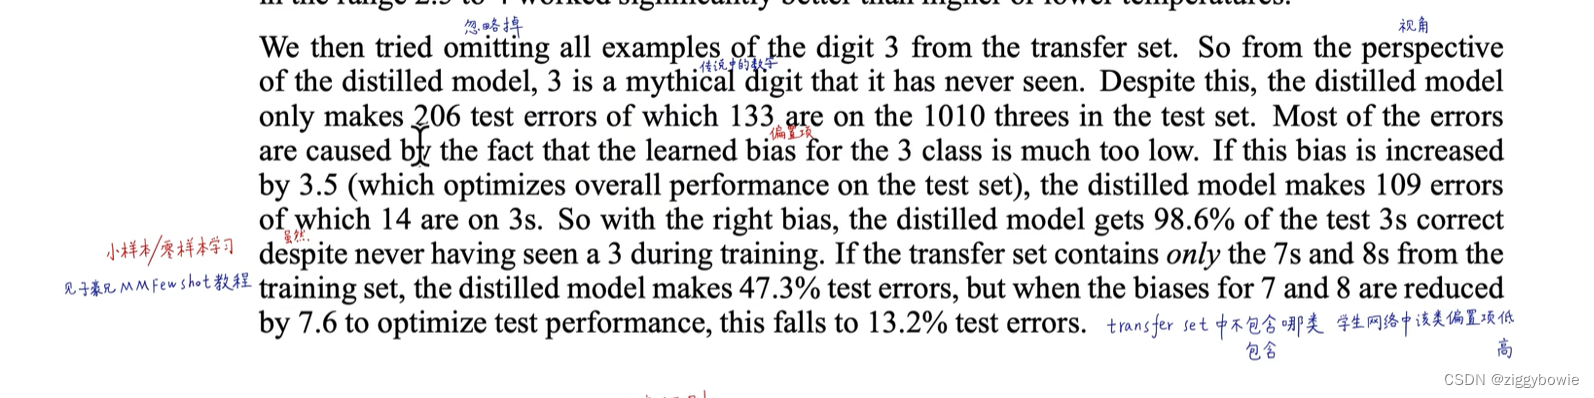
迁移学习和知识蒸馏
学生网络收敛靠近教师网络
外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传
教师模型指导哪些数据冗余
Matching logits is a special case of distillation
这部分是在知识蒸馏这篇论文之前的一个工作,是知识蒸馏提出的方法的一个特殊情况
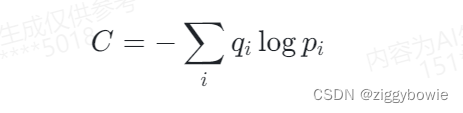
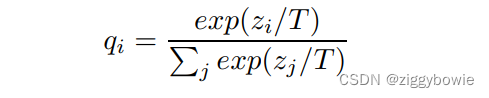
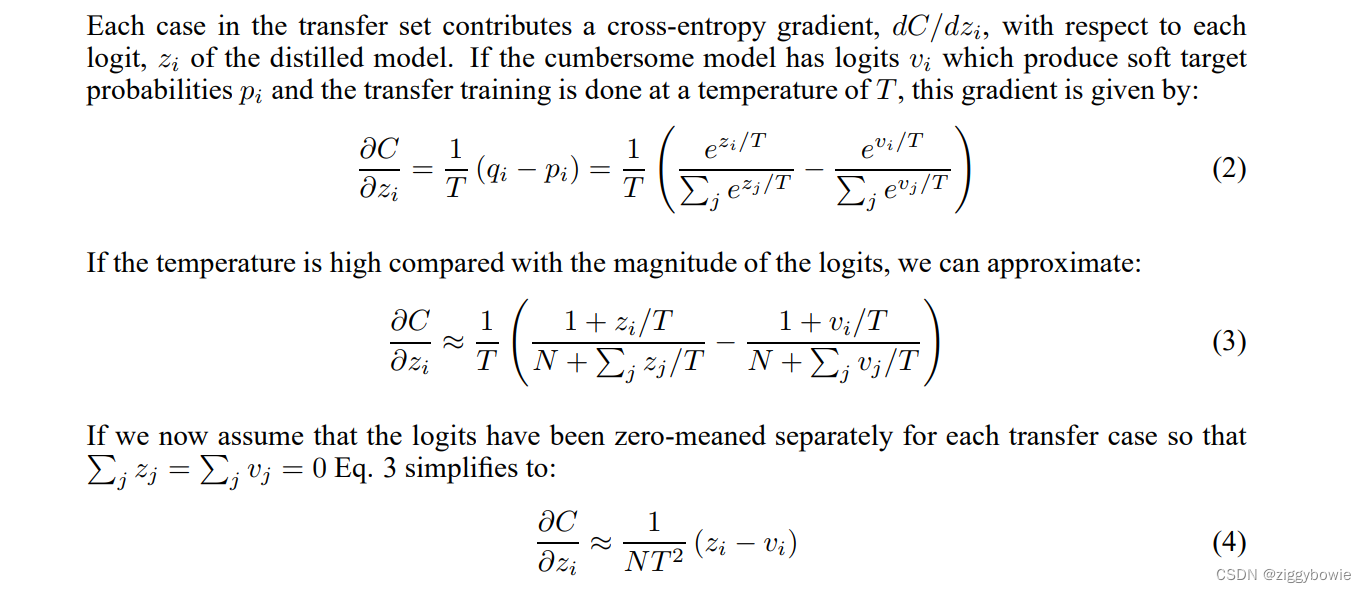
模型集成(Ensemble)
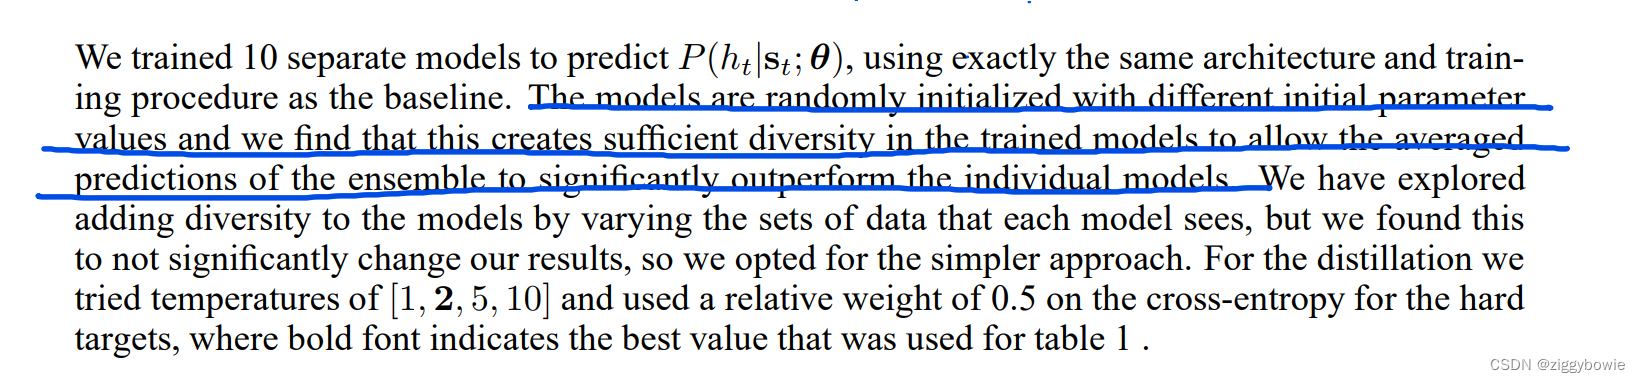
好而不同(随机初始化权重),提供足够模型的多样性,显著提升单个模型的结果
在同样的数据上训练
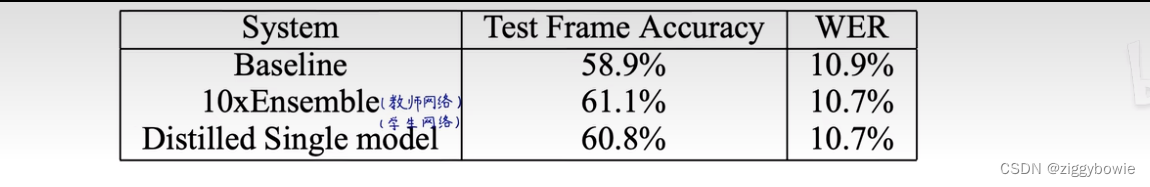
Result
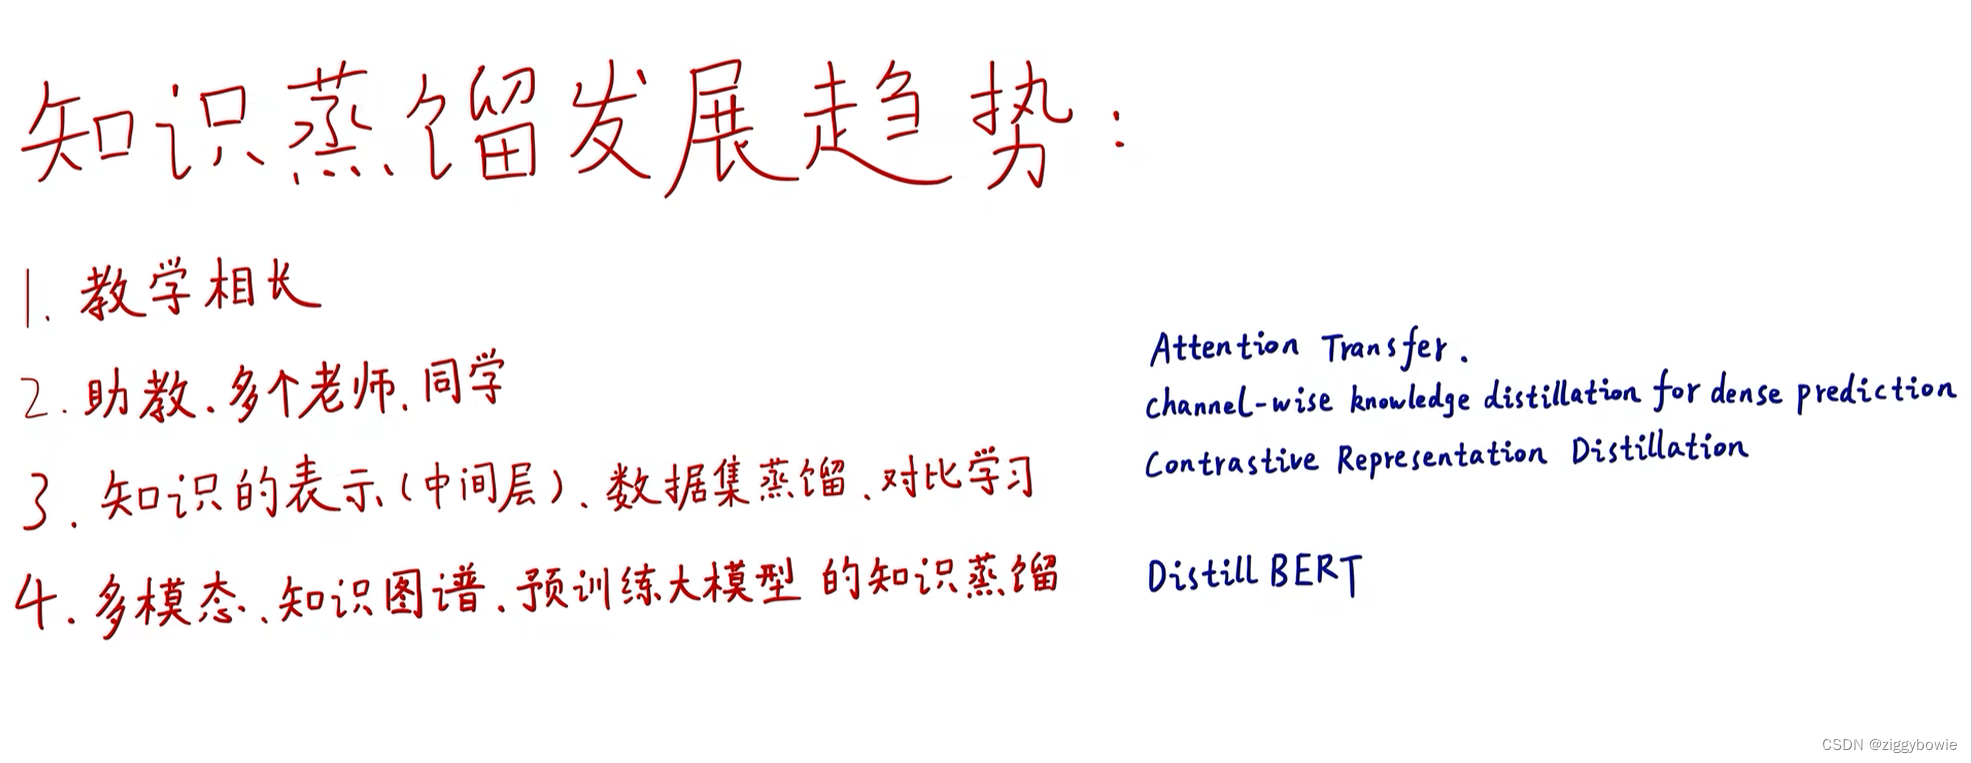
知识蒸馏研究方向
(1)教学相长,学生模型帮助老师模型,个人理解为学生模型可以学一些老师不知道的领域然后从而提升老师的能力
(2)多个老师、助教进行知识蒸馏
(3)结合对比学习、迁移学习
(4)网络中间层之间进行知识蒸馏,而不仅仅是最后结果进行知识蒸馏
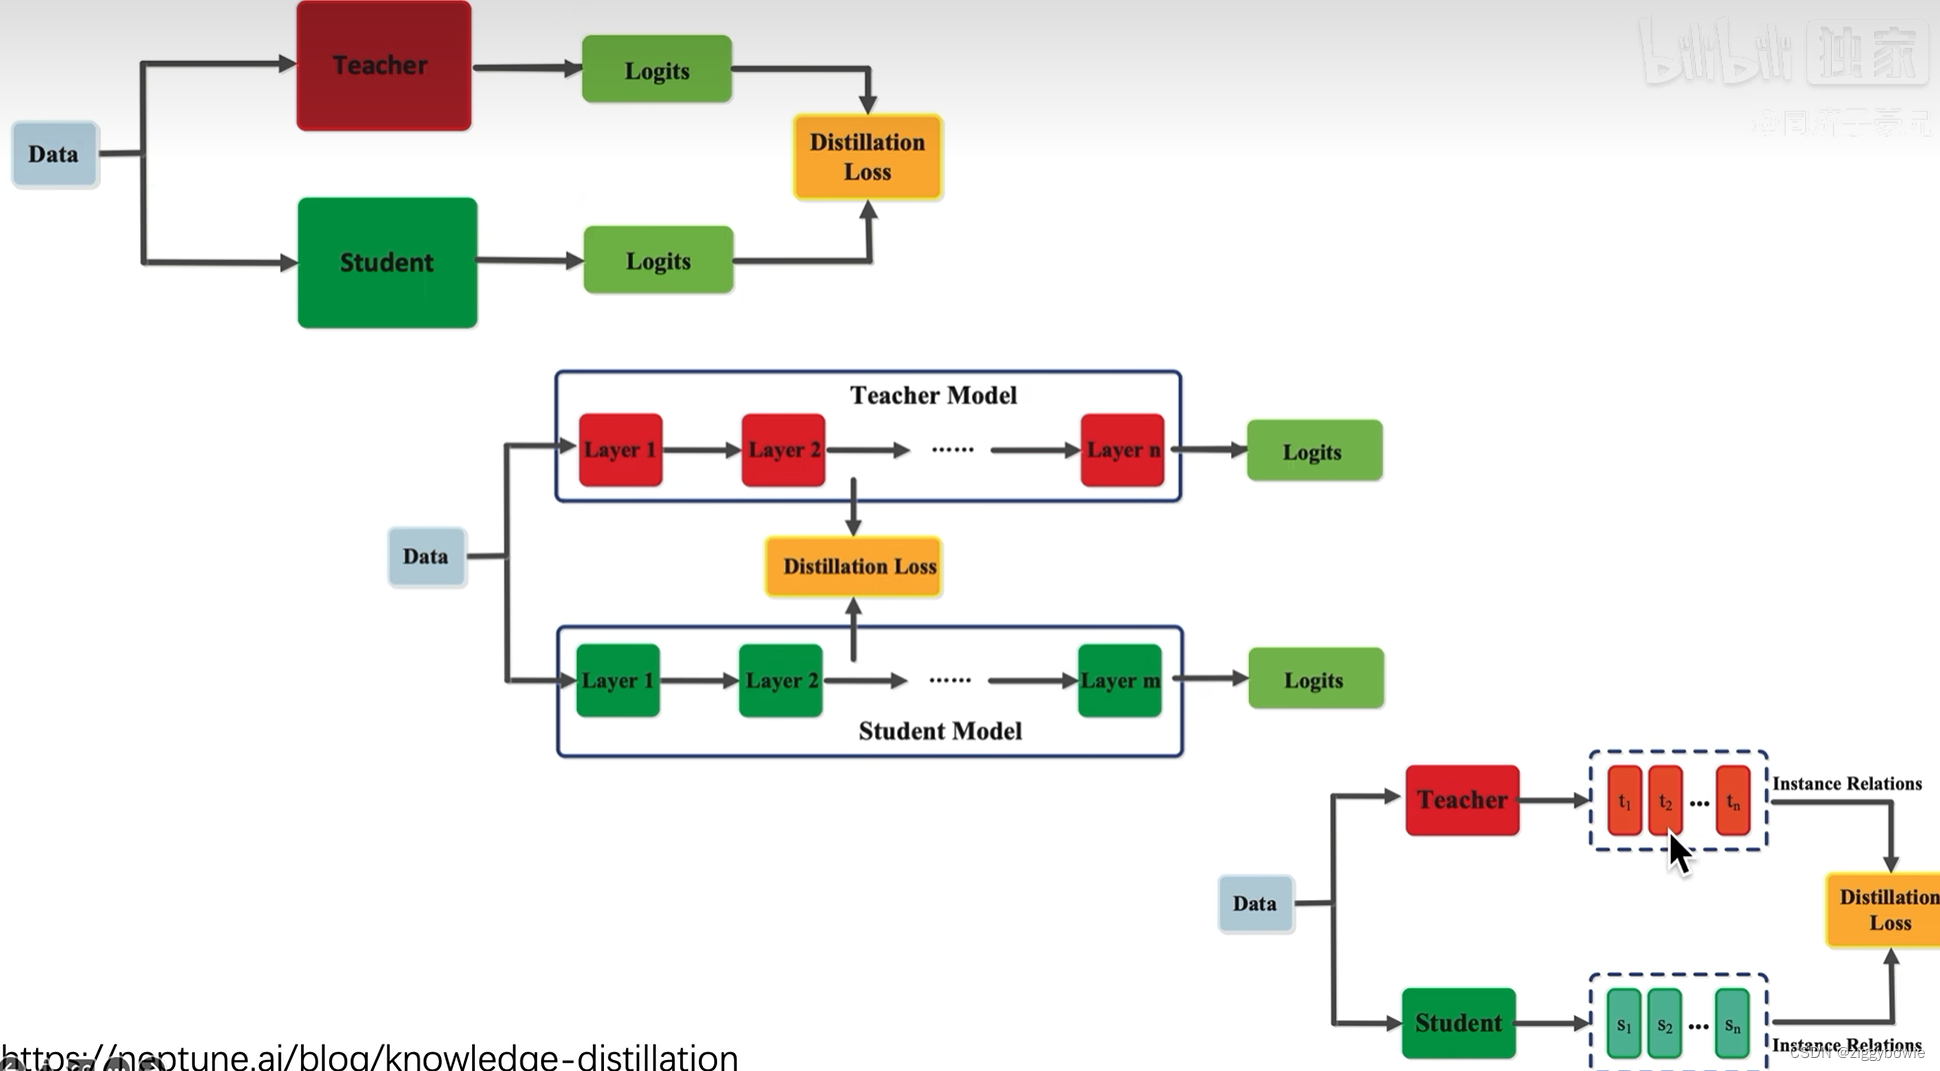
新的模型集成范式(专才模型集成)
专才模型集合,每个模型都在不同的专门数据集上训练
很多不同领域的专才模型集成在一起
但是小数据集(专门)细粒度很容易过拟合
让繁琐模型成为一个包含一个在所有数据上训练的通用模型和许多“专家”模型的集合
将其不关心的所有类别合并为一个垃圾类别
每个专家模型都使用通用模型的权重进行初始化。然后,通过使用其专用子集的一半示例和从训练集剩余部分随机抽取的另一半示例来训练专家模型
代码复现
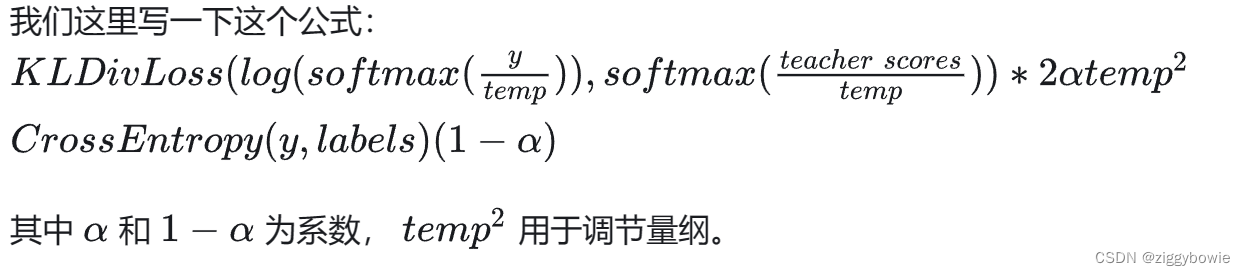
教师损失用的是cross_entropy(),即交叉熵损失函数,是有log的
import math
import torch
import torch.nn as nn
import torch.nn.functional as F
from torchvision import datasets, transforms
import torch.utils.data

torch.manual_seed(0)        # 为CPU设置种子
# torch.cuda.manual_seed(0)   # 为GPU设置种子

class TeacherNet(nn.Module):
    def __init__(self):
        super(TeacherNet, self).__init__()
        self.conv1 = nn.Conv2d(1, 32, 3, 1)     # 卷积层
        self.conv2 = nn.Conv2d(32, 64, 3, 1)    # 卷积层
        self.dropout1 = nn.Dropout2d(0.3)       # dropout
        self.dropout2 = nn.Dropout2d(0.5)       # dropout
        self.fc1 = nn.Linear(9216, 128)         # 全连接层
        self.fc2 = nn.Linear(128, 10)           # 全连接层

    def forward(self, x):
        x = self.conv1(x)
        x = F.relu(x)           # 激活函数
        x = self.conv2(x)
        x = F.relu(x)
        x = F.max_pool2d(x, 2)
        x = self.dropout1(x)
        x = torch.flatten(x, 1)
        x = self.fc1(x)
        x = F.relu(x)
        x = self.dropout2(x)
        output = self.fc2(x)
        return output
def train_teacher(model, device, train_loader, optimizer, epoch):
    model.train()
    trained_samples = 0
    for batch_idx, (data, target) in enumerate(train_loader):
        data, target = data.to(device), target.to(device)   # 将数据转移到CPU/GPU
        optimizer.zero_grad()   # 优化器将梯度全部置为0
        output = model(data)    # 数据经过模型向前传播
        loss = F.cross_entropy(output, target)  # 计算损失函数
        loss.backward()         # 反向传播
        optimizer.step()        # 更新梯度

        trained_samples += len(data)
        progress = math.ceil(batch_idx / len(train_loader) * 50) # 计算训练进度
        print("\rTrain epoch %d: %d/%d, [%-51s] %d%%" %
              (epoch, trained_samples, len(train_loader.dataset),
               '-' * progress + '>', progress * 2), end='')
def test_teacher(model, device, test_loader):
    model.eval()  # 设置为评估模式
    test_loss = 0
    correct = 0
    with torch.no_grad():  # 不计算梯度,减少计算量
        for data, target in test_loader:
            data, target = data.to(device), target.to(device)  # 将数据转移到CPU/GPU
            output = model(data)  # 经过模型正向传播得到结果
            test_loss += F.cross_entropy(output, target, reduction='sum').item()  # 计算总的损失函数
            pred = output.argmax(dim=1, keepdim=True)  # 获取最大对数概率索引
            correct += pred.eq(target.view_as(pred)).sum().item()  # pred.eq(target.view_as(pred)) 会返回一个布尔张量,其中每个元素表示预测值是否等于目标值。然后,.sum().item() 会将所有为 True 的元素相加,从而得到正确分类的数量。

    test_loss /= len(test_loader.dataset)  # 计算损失函数

    print('\nTest: average loss: {:.4f}, accuracy: {}/{} ({:.0f}%)'.format(
        test_loss, correct, len(test_loader.dataset),
        100. * correct / len(test_loader.dataset)))
    return test_loss, correct / len(test_loader.dataset)
def teacher_main():
    epochs = 10
    batch_size = 64
    torch.manual_seed(0)
    device = torch.device("cuda" if torch.cuda.is_available() else "cpu")  # 使用的设备类型

    # 导入训练集
    train_loader = torch.utils.data.DataLoader(
        datasets.MNIST('../data/MNIST', train=True, download=True,
                       transform=transforms.Compose([
                           transforms.ToTensor(),
                           transforms.Normalize((0.1307,), (0.3081,))  # 数据正则化
                       ])),
        batch_size=batch_size, shuffle=True)

    # 导入测试集
    test_loader = torch.utils.data.DataLoader(
        datasets.MNIST('../data/MNIST', train=False, download=True, transform=transforms.Compose([
            transforms.ToTensor(),
            transforms.Normalize((0.1307,), (0.3081,))  # 数据正则化
        ])),
        batch_size=1000, shuffle=True)

    model = TeacherNet().to(device)  # 传输经过教师模型网络
    optimizer = torch.optim.Adadelta(model.parameters())  # 使用Adadelta优化器

    teacher_history = []  # 记录教师得到结果的历史
    for epoch in range(1, epochs + 1):
        train_teacher(model, device, train_loader, optimizer, epoch)  # 开始训练模型
        loss, acc = test_teacher(model, device, test_loader)  # 计算损失函数和准确率
        teacher_history.append((loss, acc))  # 记录教师模型得到的历史数据

    torch.save(model.state_dict(), "teacher.pt")  # 保存到权重文件
    return model, teacher_history

teacher_model, teacher_history = teacher_main()
Downloading http://yann.lecun.com/exdb/mnist/train-images-idx3-ubyte.gz
Downloading http://yann.lecun.com/exdb/mnist/train-images-idx3-ubyte.gz to ../data/MNIST\MNIST\raw\train-images-idx3-ubyte.gz


100%|███████████████████████████████████████████████████████████████████| 9912422/9912422 [00:01<00:00, 6857460.17it/s]


Extracting ../data/MNIST\MNIST\raw\train-images-idx3-ubyte.gz to ../data/MNIST\MNIST\raw

Downloading http://yann.lecun.com/exdb/mnist/train-labels-idx1-ubyte.gz
Downloading http://yann.lecun.com/exdb/mnist/train-labels-idx1-ubyte.gz to ../data/MNIST\MNIST\raw\train-labels-idx1-ubyte.gz


100%|████████████████████████████████████████████████████████████████████████| 28881/28881 [00:00<00:00, 390897.75it/s]


Extracting ../data/MNIST\MNIST\raw\train-labels-idx1-ubyte.gz to ../data/MNIST\MNIST\raw

Downloading http://yann.lecun.com/exdb/mnist/t10k-images-idx3-ubyte.gz
Downloading http://yann.lecun.com/exdb/mnist/t10k-images-idx3-ubyte.gz to ../data/MNIST\MNIST\raw\t10k-images-idx3-ubyte.gz


100%|███████████████████████████████████████████████████████████████████| 1648877/1648877 [00:00<00:00, 2859400.30it/s]


Extracting ../data/MNIST\MNIST\raw\t10k-images-idx3-ubyte.gz to ../data/MNIST\MNIST\raw

Downloading http://yann.lecun.com/exdb/mnist/t10k-labels-idx1-ubyte.gz
Downloading http://yann.lecun.com/exdb/mnist/t10k-labels-idx1-ubyte.gz to ../data/MNIST\MNIST\raw\t10k-labels-idx1-ubyte.gz


100%|██████████████████████████████████████████████████████████████████████████████████████| 4542/4542 [00:00<?, ?it/s]
C:\Users\14366\AppData\Local\Programs\Python\Python310\lib\site-packages\torch\nn\functional.py:1345: UserWarning: dropout2d: Received a 2-D input to dropout2d, which is deprecated and will result in an error in a future release. To retain the behavior and silence this warning, please use dropout instead. Note that dropout2d exists to provide channel-wise dropout on inputs with 2 spatial dimensions, a channel dimension, and an optional batch dimension (i.e. 3D or 4D inputs).
  warnings.warn(warn_msg)


Extracting ../data/MNIST\MNIST\raw\t10k-labels-idx1-ubyte.gz to ../data/MNIST\MNIST\raw

Train epoch 1: 60000/60000, [-------------------------------------------------->] 100%
Test: average loss: 0.0509, accuracy: 9842/10000 (98%)
Train epoch 2: 60000/60000, [-------------------------------------------------->] 100%
Test: average loss: 0.0421, accuracy: 9866/10000 (99%)
Train epoch 3: 60000/60000, [-------------------------------------------------->] 100%
Test: average loss: 0.0330, accuracy: 9898/10000 (99%)
Train epoch 4: 60000/60000, [-------------------------------------------------->] 100%
Test: average loss: 0.0339, accuracy: 9883/10000 (99%)
Train epoch 5: 60000/60000, [-------------------------------------------------->] 100%
Test: average loss: 0.0313, accuracy: 9894/10000 (99%)
Train epoch 6: 60000/60000, [-------------------------------------------------->] 100%
Test: average loss: 0.0327, accuracy: 9895/10000 (99%)
Train epoch 7: 60000/60000, [-------------------------------------------------->] 100%
Test: average loss: 0.0307, accuracy: 9903/10000 (99%)
Train epoch 8: 60000/60000, [-------------------------------------------------->] 100%
Test: average loss: 0.0347, accuracy: 9904/10000 (99%)
Train epoch 9: 60000/60000, [-------------------------------------------------->] 100%
Test: average loss: 0.0324, accuracy: 9905/10000 (99%)
Train epoch 10: 60000/60000, [-------------------------------------------------->] 100%
Test: average loss: 0.0347, accuracy: 9908/10000 (99%)
学生模型的网络结构定义时一般要比教师模型简单一些,这样才能达到知识蒸馏轻量化的目的
在知识蒸馏中,通常会使用 softmax 函数将教师模型的输出转换为概率分布,然后使用对数 softmax 函数(即 log_softmax)将学生模型的输出转换为对数概率。这样做的原因是为了计算两个概率分布之间的 Kullback-Leibler 散度(KL 散度)。
KL 散度是衡量两个概率分布之间差异的一种方法。在知识蒸馏中,我们希望学生模型的输出能够尽可能地接近教师模型的输出。因此,我们使用教师模型的 softmax 输出作为“软目标”(soft targets),通过 KL 散度来衡量学生模型输出和软目标之间的相似度。
softmax 函数将输出转换为概率分布,而对数 softmax 函数则将概率分布转换为对数概率。在计算 KL 散度时,通常会使用对数概率,因为它可以简化 KL 散度的计算公式,并且能够更好地处理概率为零的情况。因此,教师模型的输出在计算 KL 散度时会使用 softmax 函数,而学生模型的输出在计算 KL 散度时会使用对数 softmax 函数。
class StudentNet(nn.Module):
    def __init__(self):
        super(StudentNet, self).__init__()
        self.fc1 = nn.Linear(28 * 28, 128)  # 全连接层
        self.fc2 = nn.Linear(128, 64)       # 全连接层
        self.fc3 = nn.Linear(64, 10)        # 全连接层

    def forward(self, x):
        x = torch.flatten(x, 1)     # 将输入张量沿着第二维度平
        x = F.relu(self.fc1(x))
        x = F.relu(self.fc2(x))
        output = F.relu(self.fc3(x))
        return output
在计算混合损失时,我们通常希望它们之和为1,因此用 (1 - alpha) 来表示交叉熵损失的权重,用 alpha 表示软目标损失的权重。
至于为什么需要使用 temp * temp * 2.0 * alpha,这是因为在使用 softmax 函数时,如果增加了温度参数,那么对于概率分布的尖锐程度就会减弱,因此为了保持损失函数中两部分的平衡,需要对软目标损失进行适当的缩放。温度参数的平方乘以2.0是一种常见的缩放方式,可以确保损失函数在不同温度参数下的表现较为稳定。
def distillation(y, labels, teacher_scores, temp, alpha):
    return nn.KLDivLoss()(F.log_softmax(y / temp, dim=1), F.softmax(teacher_scores / temp, dim=1)) * (
            temp * temp * 2.0 * alpha) + F.cross_entropy(y, labels) * (1. - alpha)


def train_student_kd(model, device, train_loader, optimizer, epoch):
    model.train()
    trained_samples = 0
    for batch_idx, (data, target) in enumerate(train_loader):
        data, target = data.to(device), target.to(device)
        optimizer.zero_grad()
        output = model(data)  # 学生模型前向传播
        teacher_output = teacher_model(data)  # 教师模型前向传播
        teacher_output = teacher_output.detach()  # 切断老师网络的反向传播
        loss = distillation(output, target, teacher_output, temp=5.0, alpha=0.7)  # 计算总损失函数,这里使用的是知识蒸馏的损失函数
        loss.backward()  # 反向传播
        optimizer.step()  # 更新参数

        trained_samples += len(data)
        progress = math.ceil(batch_idx / len(train_loader) * 50)
        print("\rTrain epoch %d: %d/%d, [%-51s] %d%%" %
              (epoch, trained_samples, len(train_loader.dataset),
               '-' * progress + '>', progress * 2), end='')

def test_student_kd(model, device, test_loader):
    model.eval()
    test_loss = 0
    correct = 0
    with torch.no_grad():
        for data, target in test_loader:
            data, target = data.to(device), target.to(device)
            output = model(data)
            test_loss += F.cross_entropy(output, target, reduction='sum').item()  # 计算总的损失函数
            pred = output.argmax(dim=1, keepdim=True)  # 获取最大对数概率索引
            correct += pred.eq(target.view_as(pred)).sum().item()  # 计算准确率
    test_loss /= len(test_loader.dataset)

    print('\nTest: average loss: {:.4f}, accuracy: {}/{} ({:.0f}%)'.format(
        test_loss, correct, len(test_loader.dataset),
        100. * correct / len(test_loader.dataset)))
    return test_loss, correct / len(test_loader.dataset)
def student_kd_main():
    epochs = 10
    batch_size = 64
    torch.manual_seed(0)
    device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
    # 加载训练集
    train_loader = torch.utils.data.DataLoader(
        datasets.MNIST('../data/MNIST', train=True, download=True,
                       transform=transforms.Compose([
                           transforms.ToTensor(),
                           transforms.Normalize((0.1307,), (0.3081,))
                       ])),
        batch_size=batch_size, shuffle=True)
    # 加载测试集
    test_loader = torch.utils.data.DataLoader(
        datasets.MNIST('../data/MNIST', train=False, download=True, transform=transforms.Compose([
            transforms.ToTensor(),
            transforms.Normalize((0.1307,), (0.3081,))
        ])),
        batch_size=1000, shuffle=True)
    # 加载学生模型
    model = StudentNet().to(device)
    optimizer = torch.optim.Adadelta(model.parameters())

    student_history = []  # 记录学生训练的模型
    for epoch in range(1, epochs + 1):
        train_student_kd(model, device, train_loader, optimizer, epoch)
        loss, acc = test_student_kd(model, device, test_loader)
        student_history.append((loss, acc))

    torch.save(model.state_dict(), "student_kd.pt")
    return model, student_history
student_kd_model, student_kd_history = student_kd_main()
C:\Users\14366\AppData\Local\Programs\Python\Python310\lib\site-packages\torch\nn\functional.py:1345: UserWarning: dropout2d: Received a 2-D input to dropout2d, which is deprecated and will result in an error in a future release. To retain the behavior and silence this warning, please use dropout instead. Note that dropout2d exists to provide channel-wise dropout on inputs with 2 spatial dimensions, a channel dimension, and an optional batch dimension (i.e. 3D or 4D inputs).
  warnings.warn(warn_msg)
C:\Users\14366\AppData\Local\Programs\Python\Python310\lib\site-packages\torch\nn\functional.py:2943: UserWarning: reduction: 'mean' divides the total loss by both the batch size and the support size.'batchmean' divides only by the batch size, and aligns with the KL div math definition.'mean' will be changed to behave the same as 'batchmean' in the next major release.
  warnings.warn(


Train epoch 1: 60000/60000, [-------------------------------------------------->] 100%
Test: average loss: 0.1918, accuracy: 9655/10000 (97%)
Train epoch 2: 60000/60000, [-------------------------------------------------->] 100%
Test: average loss: 0.1436, accuracy: 9708/10000 (97%)
Train epoch 3: 60000/60000, [-------------------------------------------------->] 100%
Test: average loss: 0.0973, accuracy: 9797/10000 (98%)
Train epoch 4: 60000/60000, [-------------------------------------------------->] 100%
Test: average loss: 0.1006, accuracy: 9795/10000 (98%)
Train epoch 5: 60000/60000, [-------------------------------------------------->] 100%
Test: average loss: 0.0862, accuracy: 9827/10000 (98%)
Train epoch 6: 60000/60000, [-------------------------------------------------->] 100%
Test: average loss: 0.0831, accuracy: 9841/10000 (98%)
Train epoch 7: 60000/60000, [-------------------------------------------------->] 100%
Test: average loss: 0.0752, accuracy: 9840/10000 (98%)
Train epoch 8: 60000/60000, [-------------------------------------------------->] 100%
Test: average loss: 0.0876, accuracy: 9826/10000 (98%)
Train epoch 9: 60000/60000, [-------------------------------------------------->] 100%
Test: average loss: 0.0754, accuracy: 9846/10000 (98%)
Train epoch 10: 60000/60000, [-------------------------------------------------->] 100%
Test: average loss: 0.0723, accuracy: 9841/10000 (98%)
def train_student_kd2(model, device, train_loader, optimizer, epoch):
    model.train()
    trained_samples = 0
    for batch_idx, (data, target) in enumerate(train_loader):
        data, target = data.to(device), target.to(device)
        optimizer.zero_grad()
        output = model(data)  # 学生模型前向传播
#         teacher_output = teacher_model(data)  # 教师模型前向传播
#         teacher_output = teacher_output.detach()  # 切断老师网络的反向传播
        loss = F.cross_entropy(output, target)  # 计算损失函数

#         loss = distillation(output, target, teacher_output, temp=5.0, alpha=0.7)  # 计算总损失函数,这里使用的是知识蒸馏的损失函数
        loss.backward()  # 反向传播
        optimizer.step()  # 更新参数

        trained_samples += len(data)
        progress = math.ceil(batch_idx / len(train_loader) * 50)
        print("\rTrain epoch %d: %d/%d, [%-51s] %d%%" %
              (epoch, trained_samples, len(train_loader.dataset),
               '-' * progress + '>', progress * 2), end='')

def test_student_kd2(model, device, test_loader):
    model.eval()
    test_loss = 0
    correct = 0
    with torch.no_grad():
        for data, target in test_loader:
            data, target = data.to(device), target.to(device)
            output = model(data)
            test_loss += F.cross_entropy(output, target, reduction='sum').item()  # 计算总的损失函数
            pred = output.argmax(dim=1, keepdim=True)  # 获取最大对数概率索引
            correct += pred.eq(target.view_as(pred)).sum().item()  # 计算准确率
    test_loss /= len(test_loader.dataset)

    print('\nTest: average loss: {:.4f}, accuracy: {}/{} ({:.0f}%)'.format(
        test_loss, correct, len(test_loader.dataset),
        100. * correct / len(test_loader.dataset)))
    return test_loss, correct / len(test_loader.dataset)


def student_kd_main():
    epochs = 10
    batch_size = 64
    torch.manual_seed(0)
    device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
    # 加载训练集
    train_loader = torch.utils.data.DataLoader(
        datasets.MNIST('../data/MNIST', train=True, download=True,
                       transform=transforms.Compose([
                           transforms.ToTensor(),
                           transforms.Normalize((0.1307,), (0.3081,))
                       ])),
        batch_size=batch_size, shuffle=True)
    # 加载测试集
    test_loader = torch.utils.data.DataLoader(
        datasets.MNIST('../data/MNIST', train=False, download=True, transform=transforms.Compose([
            transforms.ToTensor(),
            transforms.Normalize((0.1307,), (0.3081,))
        ])),
        batch_size=1000, shuffle=True)
    # 加载学生模型
    model = StudentNet().to(device)
    optimizer = torch.optim.Adadelta(model.parameters())

    student_history = []  # 记录学生训练的模型
    for epoch in range(1, epochs + 1):
        train_student_kd2(model, device, train_loader, optimizer, epoch)
        loss, acc = test_student_kd2(model, device, test_loader)
        student_history.append((loss, acc))

    torch.save(model.state_dict(), "student_kd.pt")
    return model, student_history
student_kd_model, student_kd_history = student_kd_main()
Train epoch 1: 60000/60000, [-------------------------------------------------->] 100%
Test: average loss: 0.1256, accuracy: 9613/10000 (96%)
Train epoch 2: 60000/60000, [-------------------------------------------------->] 100%
Test: average loss: 0.1028, accuracy: 9714/10000 (97%)
Train epoch 3: 60000/60000, [-------------------------------------------------->] 100%
Test: average loss: 0.0896, accuracy: 9760/10000 (98%)
Train epoch 4: 60000/60000, [-------------------------------------------------->] 100%
Test: average loss: 0.1036, accuracy: 9765/10000 (98%)
Train epoch 5: 60000/60000, [-------------------------------------------------->] 100%
Test: average loss: 0.0944, accuracy: 9756/10000 (98%)
Train epoch 6: 60000/60000, [-------------------------------------------------->] 100%
Test: average loss: 0.0965, accuracy: 9786/10000 (98%)
Train epoch 7: 60000/60000, [-------------------------------------------------->] 100%
Test: average loss: 0.0916, accuracy: 9810/10000 (98%)
Train epoch 8: 60000/60000, [-------------------------------------------------->] 100%
Test: average loss: 0.1092, accuracy: 9803/10000 (98%)
Train epoch 9: 60000/60000, [-------------------------------------------------->] 100%
Test: average loss: 0.1251, accuracy: 9745/10000 (97%)
Train epoch 10: 60000/60000, [-------------------------------------------------->] 100%
Test: average loss: 0.1159, accuracy: 9794/10000 (98%)
更多推荐
 24
 0
- 0


 已为社区贡献1条内容

所有评论(0)