登录社区云,与社区用户共同成长
邀请您加入社区
PPO(近端策略优化)是强化学习中的核心算法,用于在RLHF阶段安全优化AI模型。其核心思想是通过"近端约束"限制每次参数更新幅度,防止模型因过度追求奖励而崩溃。PPO通过生成回答、奖励评分、受控更新三步工作,确保模型稳定改进。相比新兴的DPO方法,PPO虽复杂度高但理论性能更强,被ChatGPT等早期模型采用。该算法如同给AI训练加上"安全阀",在追求高分与保持稳定性间取得平衡,成为AI对齐领域
大语言模型的表现往往遵循扩展法则,但是对于某些能力,只有当语言模型规模达到某一程度才会显现,这些能力被称为“涌现能力”,代表性的涌现能力包括三点:其一是具备上下文学习能力,可以通过完成输入文本的词序列来生成测试实例的预期输出,而无需额外的训练或梯度更新;本篇文章集中讨论了存内计算技术在加速大语言模型推理方面的潜力,从大语言模型的背景知识出发,探讨目前其面临的挑战,进而剖析两篇经典的文献以彰显存内计
2022 年底,ChatGPT 震撼上线,大语言模型技术迅速“席卷”了整个社会,人 工智能技术因此迎来了一次重要进展。面对大语言模型的强大性能,我们不禁要 问:支撑这些模型的背后技术究竟是什么?这一问题无疑成为了众多科研人员的 思考焦点。
本文摘要介绍了大型语言模型(LLM)的三个核心模块:1. 基本原理:Transformer架构的自注意力机制、上下文窗口处理及Token计算机制;2. 提示词工程(Prompt Engineering):包括Zero-shot/Few-shot提示、思维链推理(CoT)及检索增强生成(RAG)等优化方法;3. 功能调用(Function Calling):模型与外部工具的集成应用。文章通过思维导图
如果你也刚开始学 RAG,我非常建议先亲手写一个最小版本。哪怕它很简陋,只要你自己跑通一遍,理解就会完全不一样
摘要: AIGC时代的多云架构成为新趋势,打破传统单云模式的厂商锁定困境。通过构建统一的应用管理层,实现跨云标准化部署和管理,让业务自由选择最优云服务(如GCP训练、阿里云推理),同时降低迁移成本和提升灵活性。这种多云自由策略赋予企业在算力调度上的战略主动权,不再受限于单一云厂商。
随着算法、算力和数据的蓬勃发展,AI时代的曙光已然照耀全球,行业巨头们纷纷摩拳擦掌,布局人工智能赛道,催生了对AI人才的渴求。在这个充满机遇的时代,产品经理如何才能抓住AI的风口,快速入行,抢占职业先机呢?
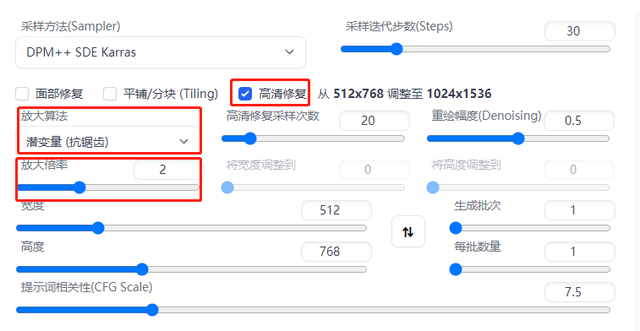
我们在用 stable diffusion制作AI图片时,默认生成图片的尺寸为512512,即使是竖图一般也就是512768,如果再把尺寸设置大一些,就会因为硬件算力不够而造成系统崩溃,今天就来跟大家聊一聊,如何将制作好的小图无损放大,得到一张高分辨率的大图。AI绘画功能强大,不仅可以将小图片进行高清无损放大,而且还能精细还原细节,小图片高清无损放大,分分钟搞定,单张、批量均可,免费不花钱。(文末
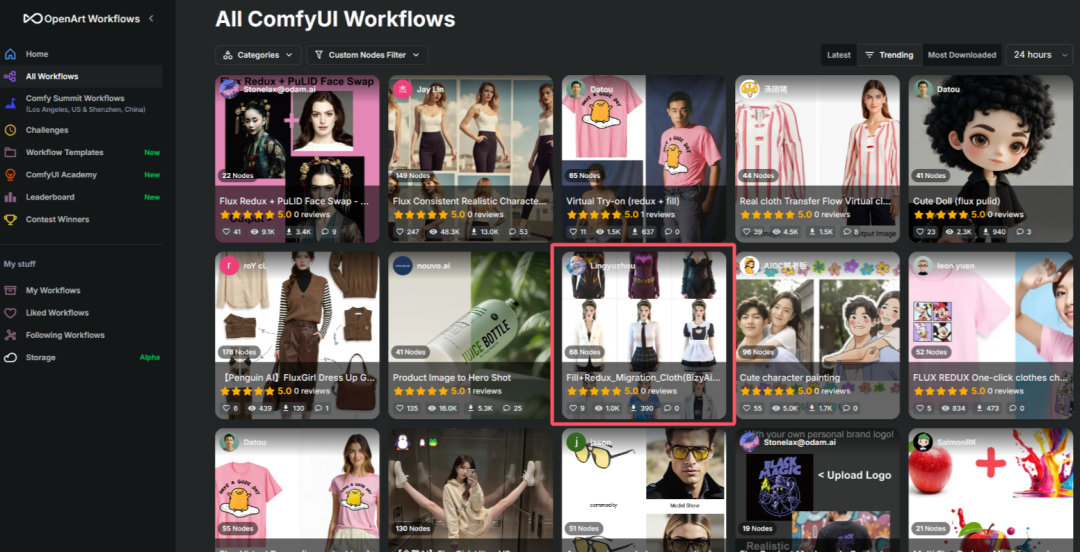
一键换装,热度爆表!今天,老韩给大伙带来一款超厉害的换装工作流,它出自兄弟Lingyuzhou之手,基于BizyAir云节点打造,还登上了OpenArt首页,那排面,简直拉满!这套工作流采用了FlUX.1 Fill和Redux模型,全程在BizyAir云端运行,本地算力纹丝不动,这对配置不高的电脑来说,妥妥的救星啊!而且,它的运行速度快得惊人,不知道把那些配备A100芯片的设备甩开了多少条街,硅基
读完这篇《2028全球智能危机》,你是觉得这只是危言耸听的“思想实验”,还是已经感受到了暴风雨前的宁静?它不是在预测AI会失败,恰恰相反,它假设AI所有的牛逼都实现了:算力爆炸、效率逆天、利润狂飙。这就是报告中提到的**“幽灵GDP”**:数据看起来还在涨,但那是机器之间的内循环,跟人类的幸福感毫无关系。你有没有想过,现代经济70%是靠“人类的弱点”撑起来的。因为市场只定价了AI的成功,却没定价“
,部分目录如下,请读者搜索关键字,获取报告,学习参阅。32、从ChatGPT到生成式AI(Generative AI):人工智能新范式,重新定义生产力(2023)329、人工智能专题研究(2):AI大模型开展算力竞赛,打开AI芯片、光模块和光芯片需求。61、ChatGPT专题研究之一:探寻ChatGPT能力圈,以及破圈之路(2023)238、AI大模型市场研究报告(2023):迈向通用人工智能,大
继ChatGPT开启大语言模型引领的新一轮人工智能革命以来,我们持续见证了人工智能领域技术的加速迭代,世界各地知名大企公司陆续推出了大模型和技术创新产品,标志着大模型技术的成熟和大规模应用的开始。趋势1 算力底座**:**迈向十万卡集群量变,速度和效率双提升。趋势2 推理分析**:**LLM带来推理能力跃迁,开启“智力即服务”新模式。趋势3 创意生成:AIGC应用爆发,降低专业创作门槛。趋势4 情
随着科技的不断进步和数据驱动的时代到来,越来越多的开发者和数据研究人员需要强大的计算能力来支持他们的工作,尤其是在处理大规模数据、进行机器学习和人工智能等高性能应用方面,对GPU算力的需求变得越来越迫切。
DaSiWa-WAN 2.2 I2V 14B模型使用指南:该模型包含8个版本(v1-v8.1),每个版本有独特名称如SweetSpot、TastySin等。主要特点包括内置Lightning支持4步流畅运行、优化动作流畅度、增强动漫视频处理能力。建议参数:4步数、CFG 1、720p分辨率,推荐Euler+Simple或RES_Multistep采样器。本地部署需16G显存+32G内存,模型可从魔
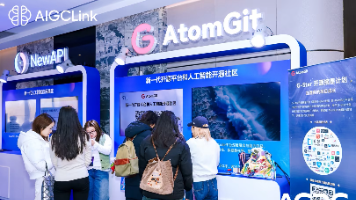
等领域的优势 —— 从支持 AI 项目全流程开发的协作功能,到助力开发者降低研发门槛的资源支持,全方位呈现了 AtomGit 如何为开发者提供 “一站式” 工具支撑,为 AIGC 创作注入开源动力。期间,众多开发者驻足咨询,就 AI 项目托管、多团队协同、算力资源对接等需求展开深入交流,现场互动氛围热烈。此次参会,AtomGit 不仅同步了 AIGC 产业最新趋势,更与产业链伙伴建立了紧密联结。生
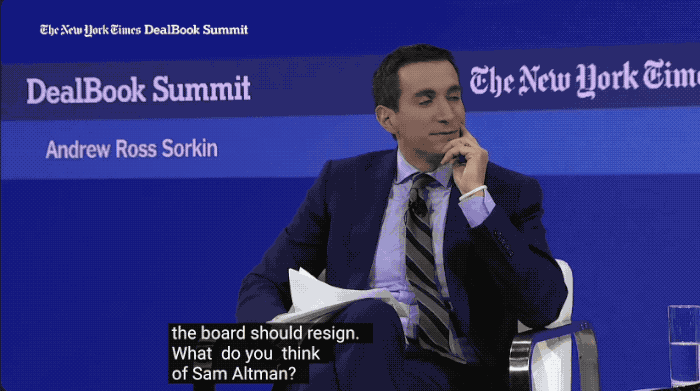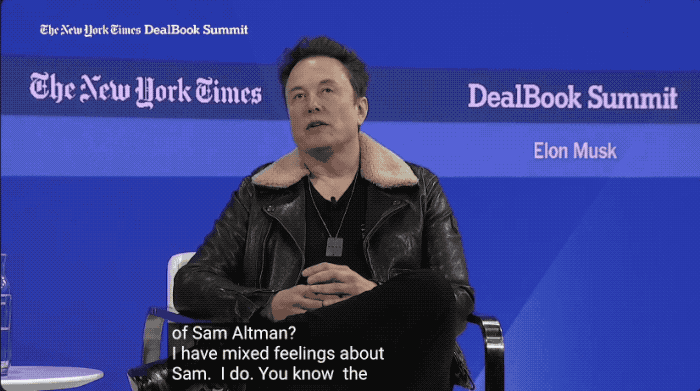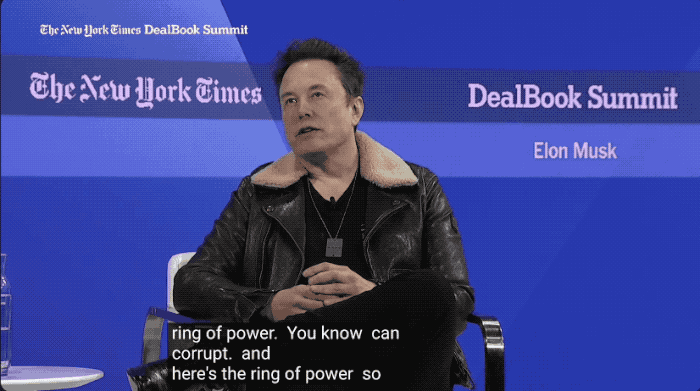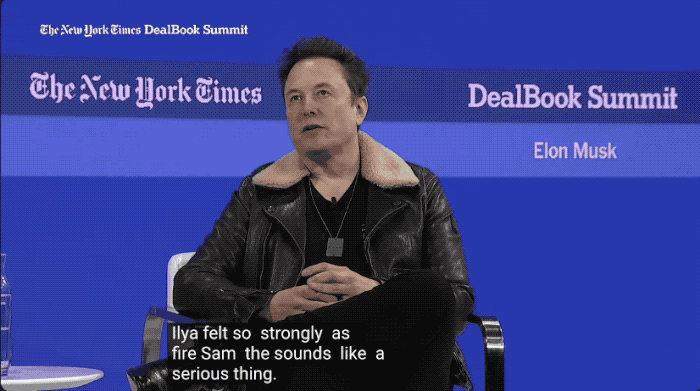
当主持人把话题转向“那么你的AI事业与OpenAI、谷歌如何相比”时,马斯克表示自己从30年前上大学时,就开始思考AI会带来的影响。他之所以此前没有大规模投入AI研发,就是想先搞明白“这把双刃剑到底哪边更锋利”,也就是AI给人类带来的好处更多,还是危害更多。插播一句题外话,就在马斯克接受采访的同一天,奥特曼也首次回应了关于Q*的传闻,称“这是一个不幸的泄密事件”。他联合创办OpenAI的初衷是制衡
当前AI与金融的结合主要有两条技术路径:一是通用模型+金融语料微调大模型,二是预训练成金融垂类大模型。由于设计和训练目的不同,通用语言大模型与金融垂类模型在优劣上具有相对性。预训练是预先训练模型的过程,微调是将预训练过后的模型作用于自己的专业数据 集;从海外实践情况来看,目前国外成功的预训练金融垂类模型主要BloombergGPT,其他公司为节省成本,采用通用大模型+特定领域数据微调方式的较多,对
实验中,OpenAI在o1-preview和o1-mini模型上验证了新技术的有效性,结果显示,模型成功抵御了包括Many-shot、Soft Token Attack和Human Red-teaming Attack在内的多种攻击。在增加推理时间和算力资源的情况下,模型均成功抵御了这些攻击。近屿智能积极响应当前AI技术趋势,期待为行业输送更多高素质、高技能的AIGC专业人才,因此精心策划并推出了
金融科技企业或者银行客户都面临一个非常大的挑战,数据、算力、算法三个层面是大模型最关键的,数据首先不能出去,要训练私有领域的模型,数据量相对小一些,这个量对于大模型来说训练的时候数量不到一定程度,训练的效果又受影响,这个方面又对技术或者模型深度方面有一些考虑,这是第一个大的挑战。薛春雨认为,从机遇的角度来说,其实大家知道AIGC是生成式的,不管是之前的纯文本,现在是多模态的生成,在这个层面来说,不
北京先智先行科技有限公司,凭借 “先知大模型”“先行 AI 商学院”“先知 AIGC 超级工场” 三款旗舰产品,在人工智能技术应用领域成绩斐然。公司围绕 AI 打造五大核心业务:先知大模型私有化部署、先知 AIGC 超级工场、AI 训练师、先知人力资源服务、先知产业联盟,在行业内迅速崛起。基于先知 AI 多模态大模型算力底座,对企业私有知识库预训练,让 AI 训练师进行微调,生成精度可达 99%。
Meta旗下第三代大模型Llama 3终于在本周正式亮相:最大参数规模超4000亿,训练token超15万亿,对比GPT-3.5多种人类评估测评胜率超六成,官方号称“地表最强开源模型”。在各大科技巨头的“内卷”中,大模型终于来到了一个关键的转折点。摩根士丹利指出,世界正在进入一个由硬件和软件共同推动的大模型能力快速增长的新时代,大模型在创造力、战略思维和处理复杂多维任务方面的能力将显著提升。报告强
在蒸汽机发明后,力气大不再是优势;在AI时代,会画图也不再是护城河。