01-大模型概述
AI将无处不在,新时代🐮🐴分层
🐮🐴分层:
产品使用者【使用者人人都是】< 产品制造者【基于大模型,设计和开发 AI 产品】< 基础模型相关【训练基础大模型,或为大模型提供基础设施】
AI大模型是什么?
大模型,全称「大语言模型」,英文「Large Language Model」,缩写「LLM」。是当前人工智能领域的重要发展方向,通常指基于海量数据和庞大参数规模训练的语言模型。以下是一些关键点总结:
核心特点
- 参数量大:通常包含数十亿甚至万亿级参数(如GPT-3参数量达1750亿)。
- 训练数据广泛:使用互联网文本、书籍、代码等多领域数据进行预训练。
- 通用性强:可处理文本生成、翻译、问答、代码编写等多样化任务。
技术基础
-
Transformer架构:
基于自注意力机制(Self-Attention)的模型结构(如GPT系列、PaLM等)。 -
预训练+微调:
先通过无监督学习从数据中提取通用特征,再针对特定任务微调。 -
提示工程(Prompt Engineering):
通过设计输入提示(Prompt)引导模型输出所需结果。
典型代表
- GPT系列(OpenAI):如ChatGPT(基于GPT-3.5/GPT-4)。
- BERT(Google):双向Transformer,擅长理解类任务。
- LLaMA(Meta):开源模型,参数量从70亿到650亿不等。
- Gemini(Google):多模态大模型,支持文本、图像等输入。
应用场景
- 自然语言处理:聊天机器人、内容生成、文本摘要。
- 编程辅助:GitHub Copilot等代码生成工具。
- 知识问答:替代传统搜索引擎提供直接答案。
- 跨模态任务:结合图像、音频的多模态模型(如GPT-4V)。
挑战与争议
- 算力需求:训练需高性能GPU集群,成本极高。
- 幻觉问题:可能生成虚假或误导性内容。
- 伦理风险:数据偏见、隐私泄露、滥用(如伪造信息)。
知名的产品
| 国家 | 公司 | 对话产品 | 旗舰大模型 | 网址 |
|---|---|---|---|---|
| 美国 | OpenAI | ChatGPT | GPT | https://chatgpt.com/ |
| 美国 | Microsoft | Copilot | GPT 和未知 | https://copilot.microsoft.com/ |
| 美国 | Gemini | Gemini | https://gemini.google.com/ | |
| 美国 | Anthropic | Claude | Claude | https://claude.ai/ ,公认不输甚至超过 GPT 的 |
| 中国 | 百度 | 文心一言 | 文心 | https://yiyan.baidu.com/ |
| 中国 | 阿里云 | 通义千问 | 通义千问 | https://tongyi.aliyun.com/qianwen |
| 中国 | 智谱 AI | 智谱清言 | GLM | https://chatglm.cn/ |
| 中国 | 月之暗面 | Kimi Chat | Moonshot | https://kimi.moonshot.cn/ |
| 中国 | MiniMax | 星野 | abab | https://www.xingyeai.com/ |
| 中国 | 深度探索 | deepseek | DeepSeek | https://chat.deepseek.com/ |
- 要能体验ChatGPT,最好搞一个ChatGPT Plus 会员
- DeepSeek是 ChatGPT 免费平替
- 大模型不只是聊天机器人!大模型不只是聊天机器人!大模型不只是聊天机器人!
使用案例【转载】
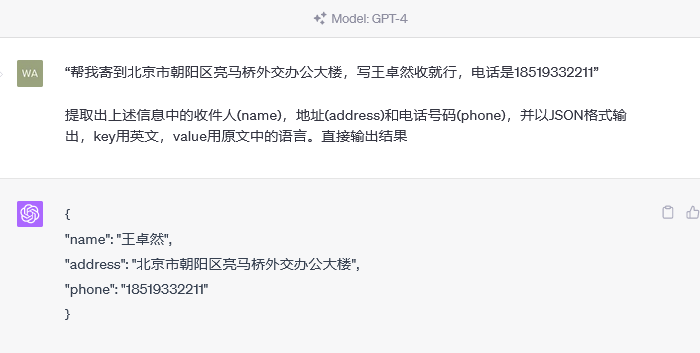
按格式输出
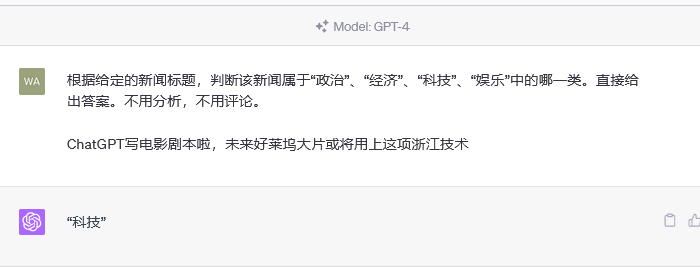
分类
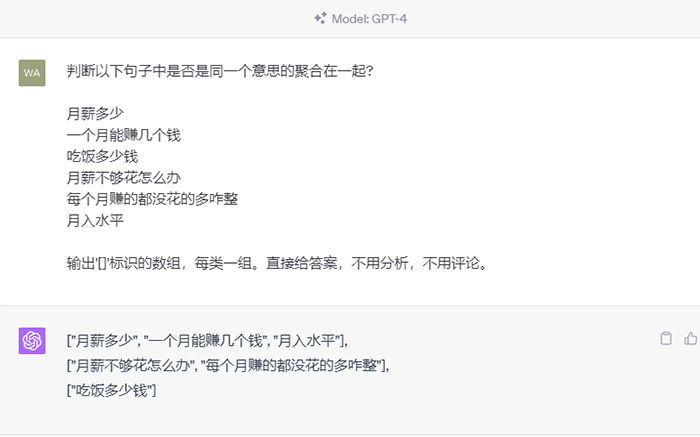
聚类
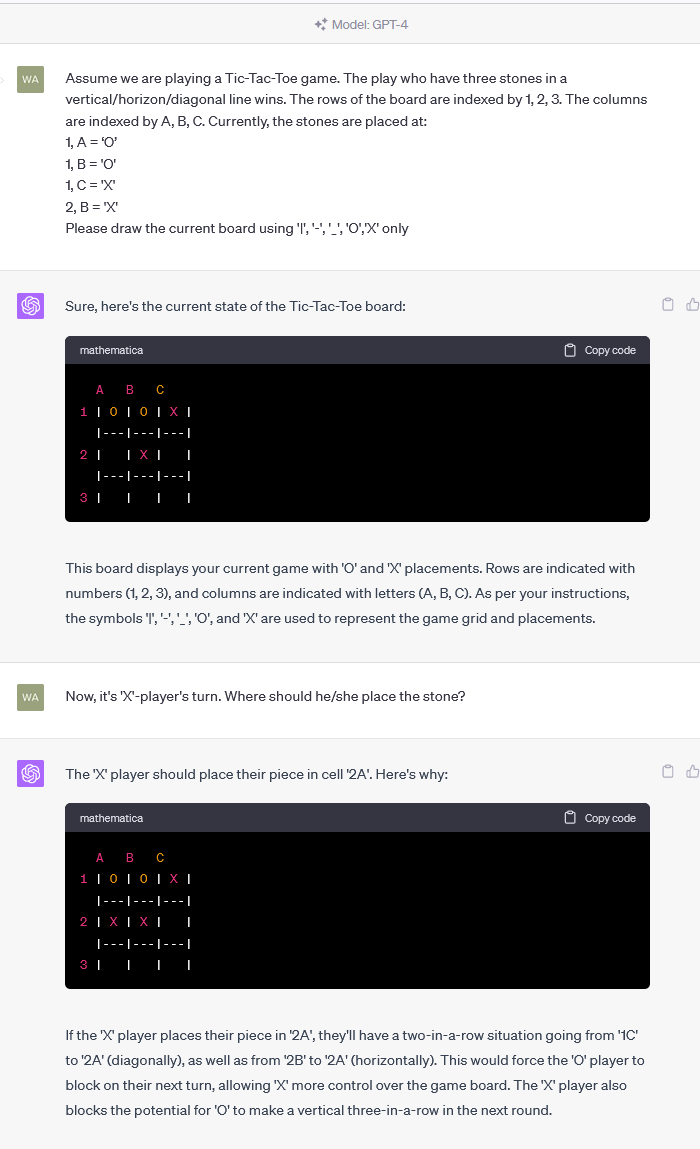
技术相关问题
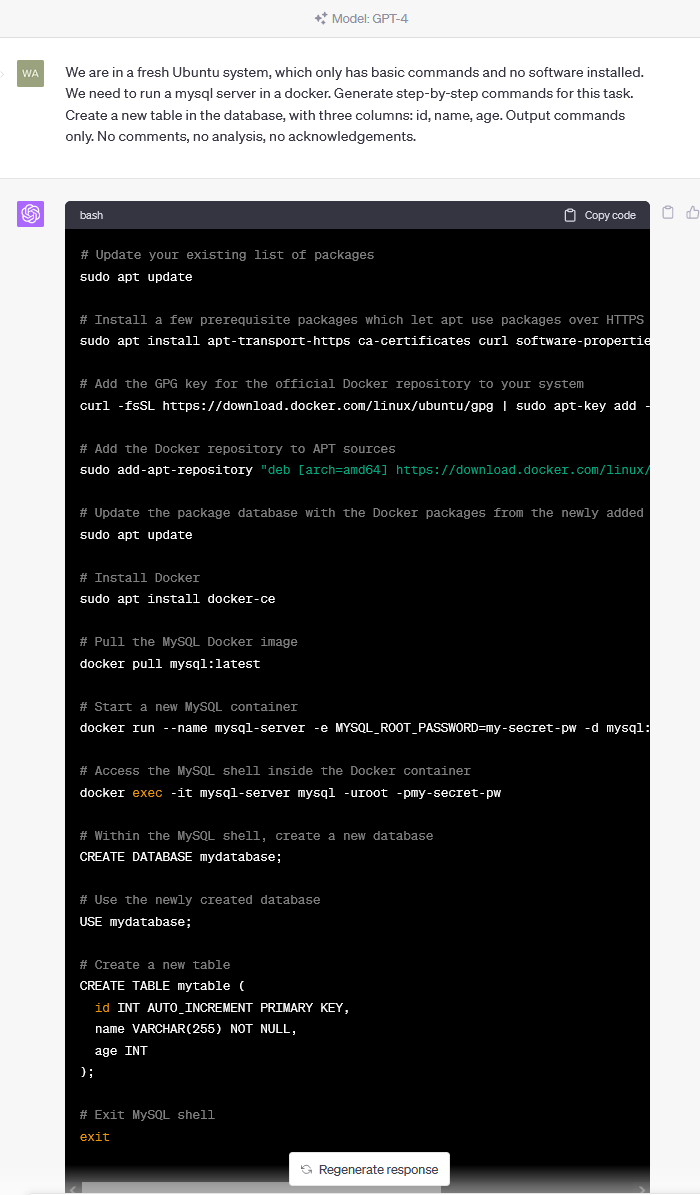
可能一切问题,都能解决,所以是通用人工智能 AGI
用 AI,要用「用人思维」:
- 机器思维:研发了什么功能,就有什么功能。
- 用人思维:给 ta 一个任务,总会有些反馈,或好或坏,惊喜或惊吓。
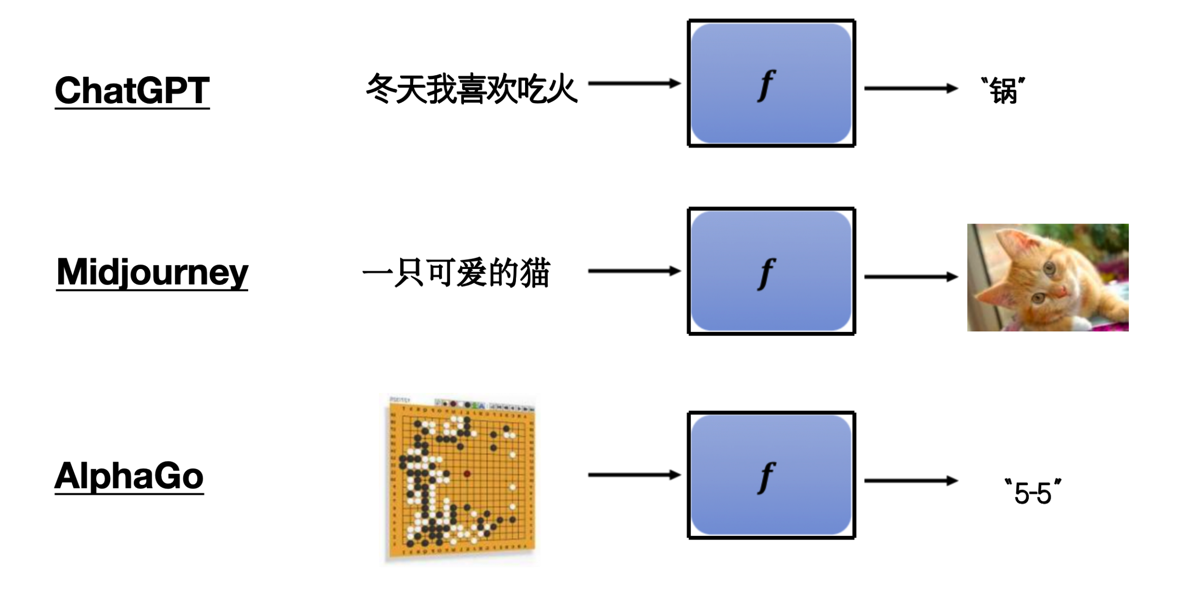
大模型就是一个函数,给输入,生成输出
任何可以用语言描述的问题,都可以输入文本给大模型,就能生成问题的结果文本
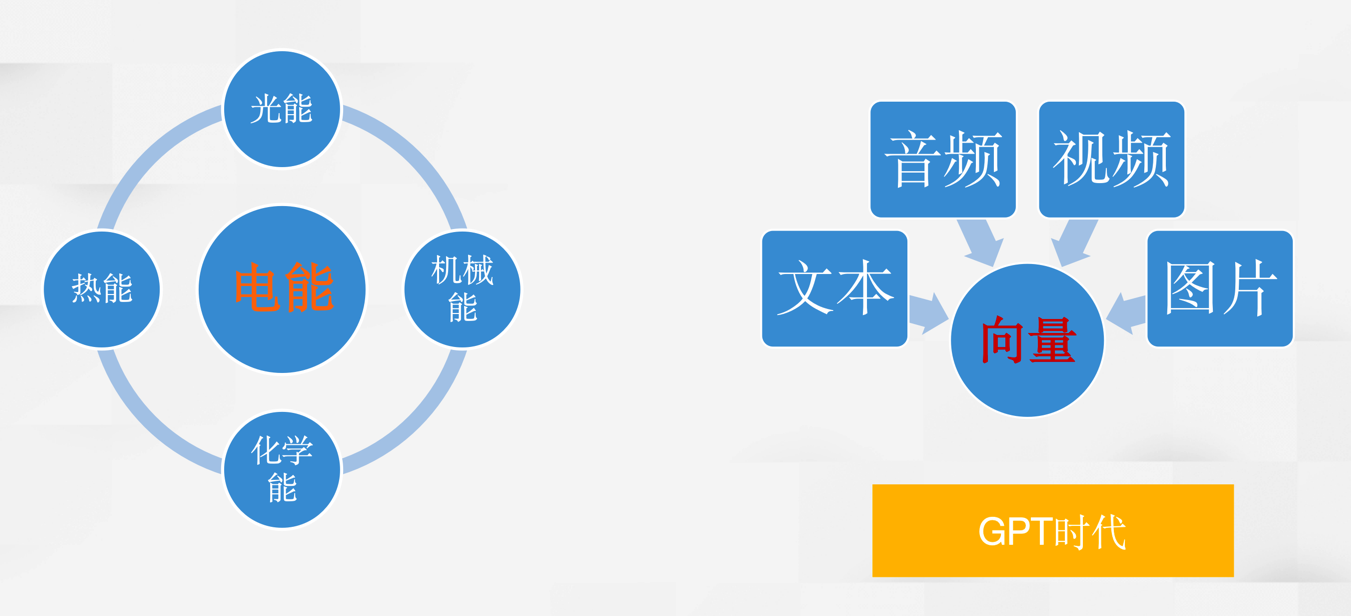
进而,任意数据,都可以输入给大模型,生成任意数据
大模型GPT时代:一切皆为向量
大模型是怎样工作的?
通俗原理
其实,它只是根据上文,猜下一个词(的概率)……
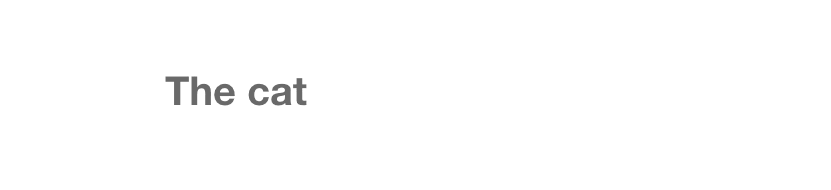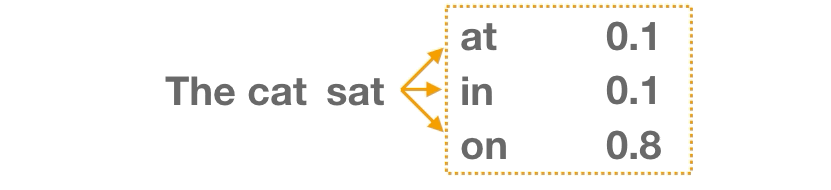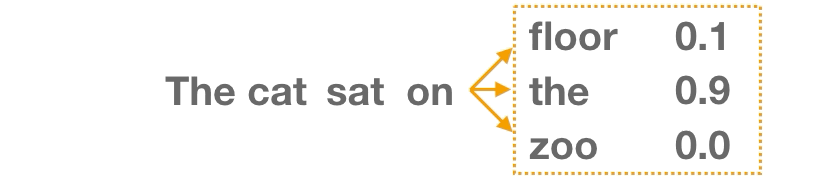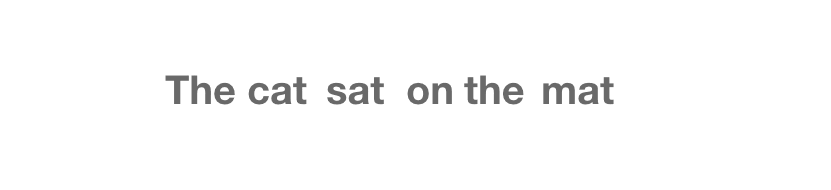
OpenAI 的接口名就叫「completion」,也证明了其只会「生成」的本质。
下面用程序演示「生成下一个字」。你可以自己修改 prompt 试试。还可以使用相同的 prompt 运行多次。
from openai import OpenAI

from dotenv import load_dotenv, find_dotenv
_ = load_dotenv(find_dotenv())

client = OpenAI()

prompt = "今天我很"  # 改我试试
# prompt = "下班了,今天我很"
# prompt = "放学了,今天我很"
# prompt = "AGI 实现了,今天我很"
response = client.completions.create(
    model="gpt-3.5-turbo-instruct",
    prompt=prompt,
    max_tokens=512,
    stream=True
)

for chunk in response:
    print(chunk.choices[0].text, end='')

## output
开心,
因为我很期待明天
明天是个全新的一天
有数不尽的可能性等着我
我可以充满激情地迎接新的挑战
我可以抓住每一次机会
让自己变得更强大
我可以满怀希望地面对未来
相信自己能够实现梦想
今天的快乐会成为明天的动力
让我更加勇敢地追求美好的生活
无论遇到什么困难
我都会坚持不懈
勇敢前行,努力奋斗
因为明天的希望就在前方
我相信明天会更加美好
所以今天,我感到无比幸福和满足。
略深一点的通俗原理
训练和推理是大模型工作的两个核心过程。
用人类比,训练就是学,推理就是用。学以致用,如是也。
例如,有下面训练数据:
- AI 正在改变我们的生活方式。
- AI 技术在医疗领域有广泛应用。
- AI 可以提高企业的生产效率。
- AI 算法能够预测市场趋势。
- AI 在自动驾驶汽车中扮演重要角色。
- AI 有助于个性化教育的发展。
- AI 机器人可以执行复杂的任务。
- AI 技术正在推动智能家居的普及。
- AI 在金融分析中发挥着关键作用。
- AI 技术正逐步应用于艺术创作。
「AI」之后出现「技」的概率大于其它字。这些字之间的概率关系,就是大模型训练时学到的。
用不严密但通俗的语言描述原理:
- 大模型阅读了人类说过的所有的话。这就是「机器学习」
- 训练过程会把不同 token 同时出现的概率存入「神经网络」文件。保存的数据就是「参数」,也叫「权重」
- 我们给推理程序若干 token,程序会加载大模型权重,算出概率最高的下一个 token 是什么
- 用生成的 token,再加上上文,就能继续生成下一个 token。以此类推,生成更多文字
Token 是什么?
- 可能是一个英文单词,也可能是半个,三分之一个
- 可能是一个中文词,或者一个汉字,也可能是半个汉字,甚至三分之一个汉字
- 大模型在开训前,需要先训练一个 tokenizer 模型。它能把所有的文本,切成 token
- AI 做对的事,怎么用这个原理解释?
- AI 的幻觉,一本正经地胡说八道,怎么用这个原理解释?
再深一点点
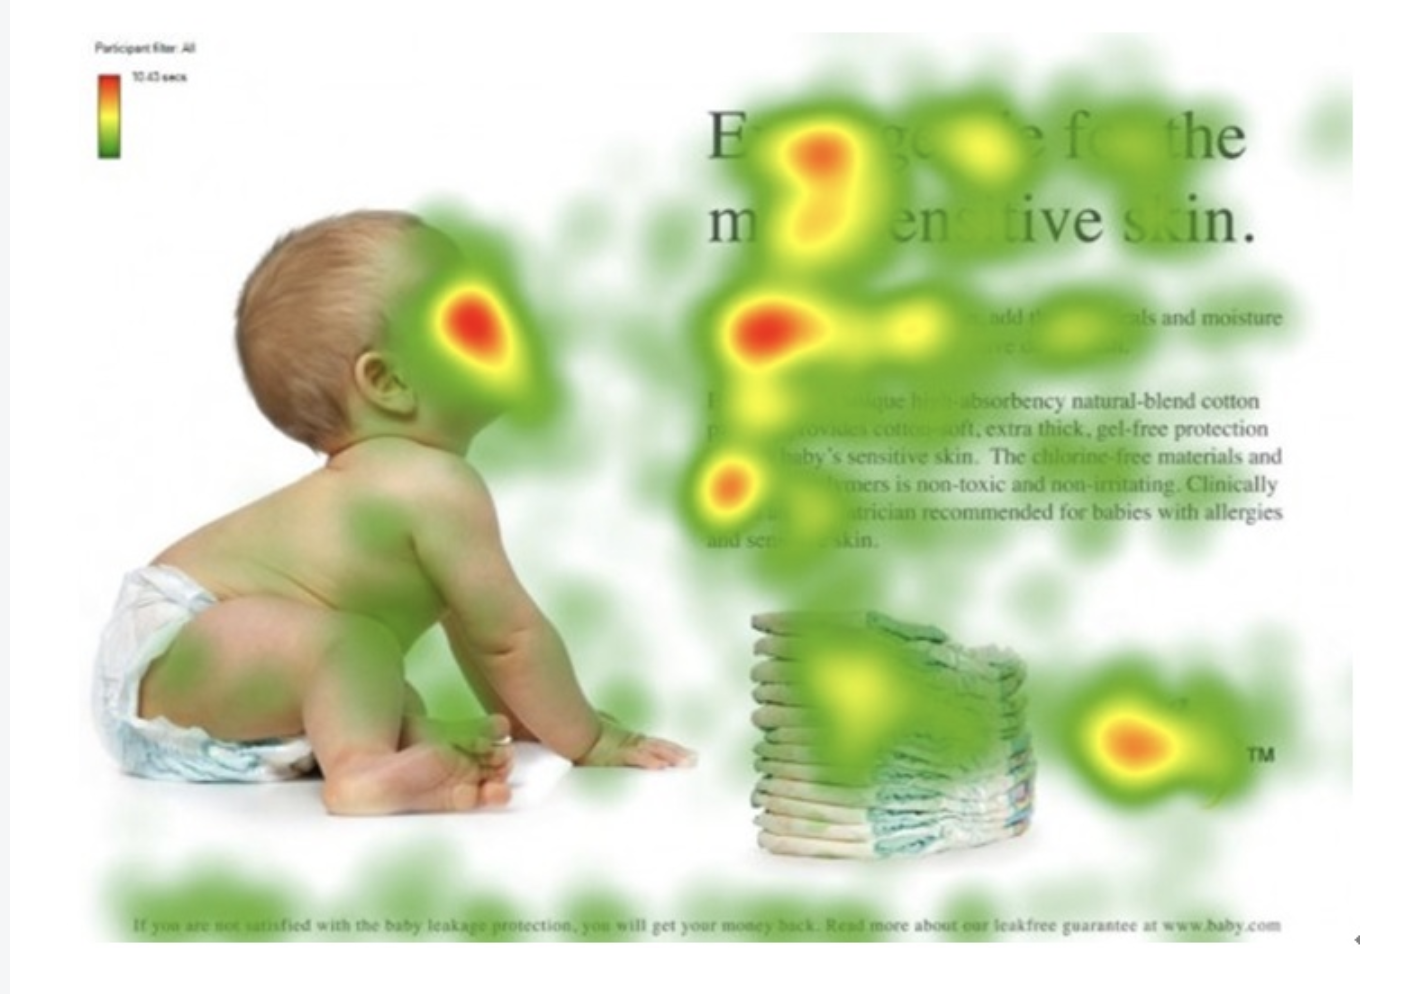
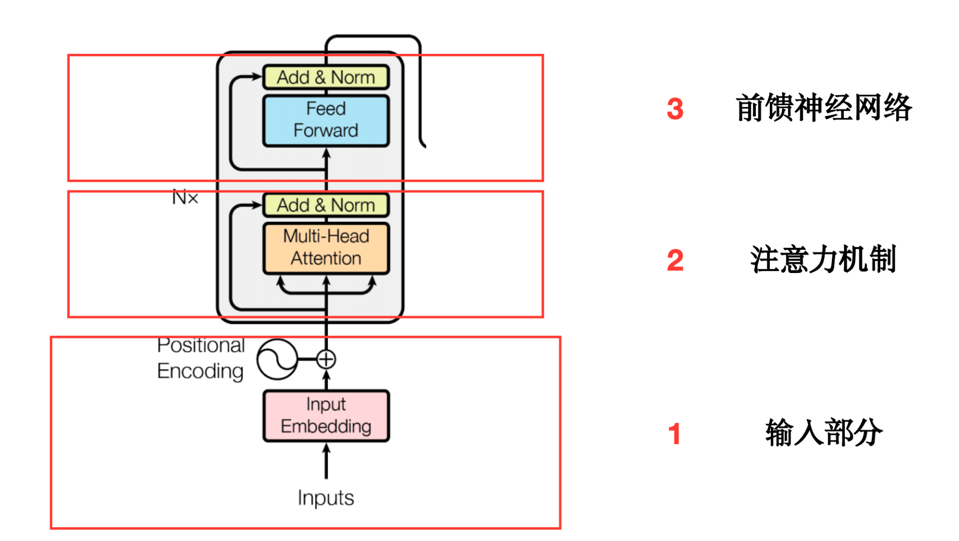
- 这套生成机制的内核叫「Transformer 架构」
- Transformer 是目前人工智能领域最广泛流行的架构,被用在各个领域
- Transformer 仍是主流,但并不是最先进的
| 架构 | 设计者 | 特点 | 链接 |
|---|---|---|---|
| Transformer | 最流行,几乎所有大模型都用它 | OpenAI 的代码 | |
| RWKV | PENG Bo | 可并行训练,推理性能极佳,适合在端侧使用 | 官网、RWKV 5 训练代码 |
| Mamba | CMU & Princeton | 性能更佳,尤其适合长文本生成 | GitHub |
| Test-Time Training (TTT) | Stanford, UC San Diego, UC Berkeley & Meta AI | 速度更快,长上下文更佳 | GitHub |
目前只有 transformer 被证明了符合 scaling-law。
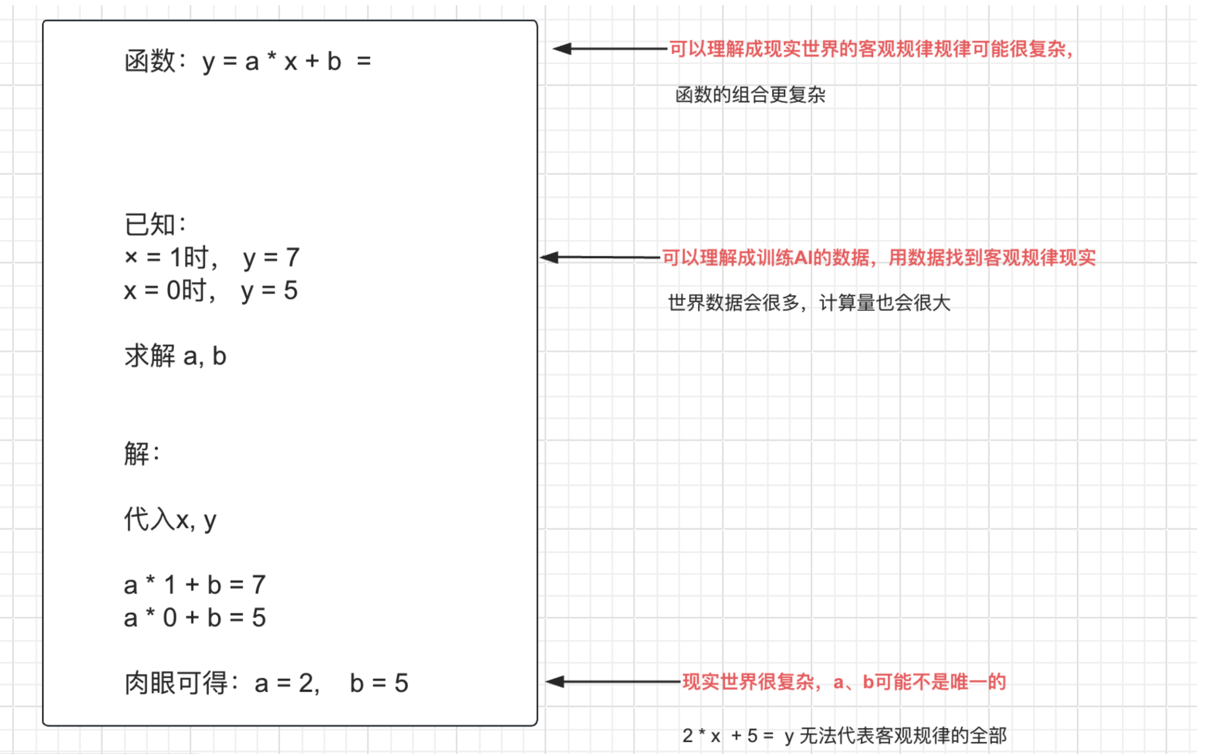
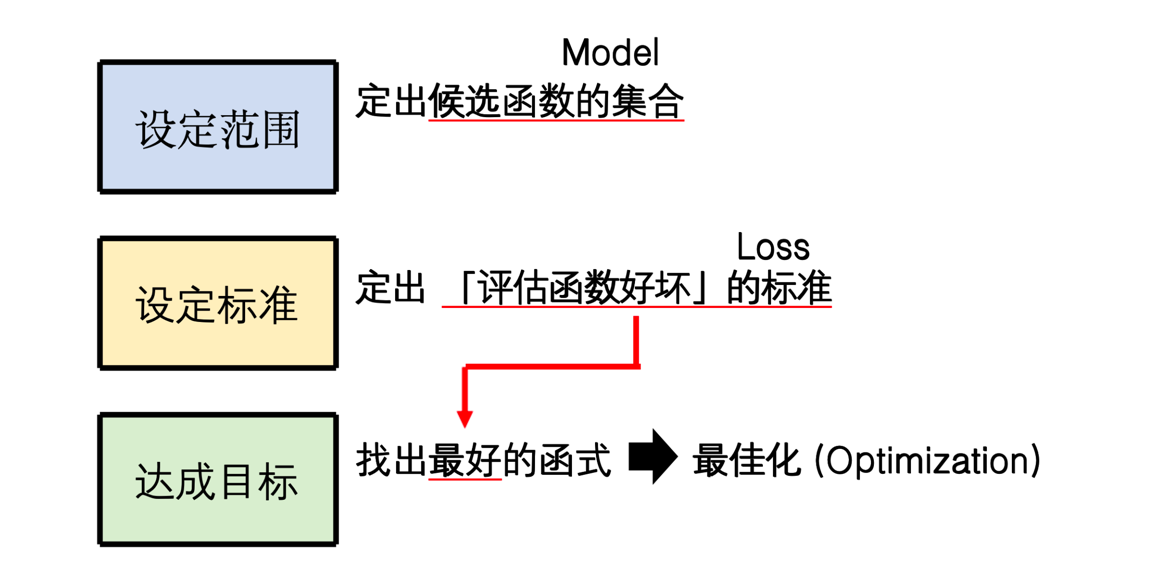
机器学习 ≈ 机器自动找一个函数
函数的参数
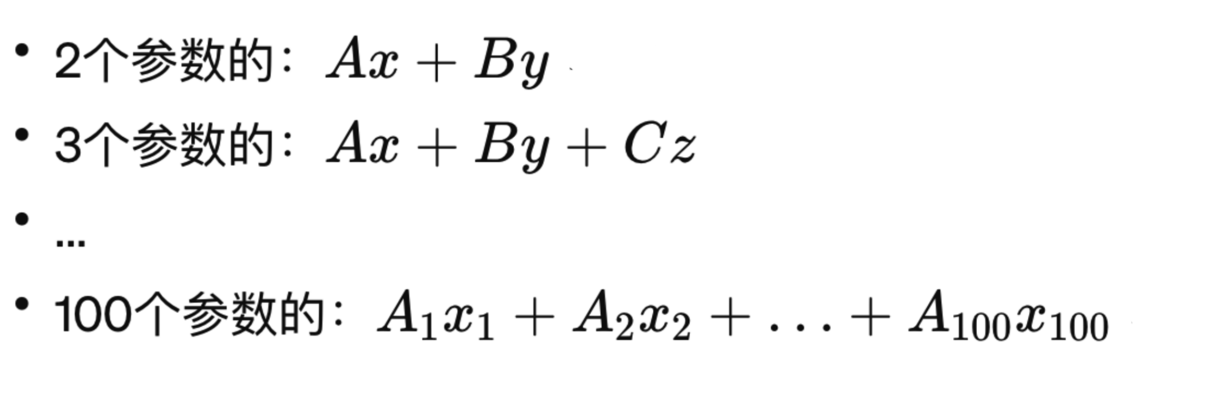
找出函数的三步骤
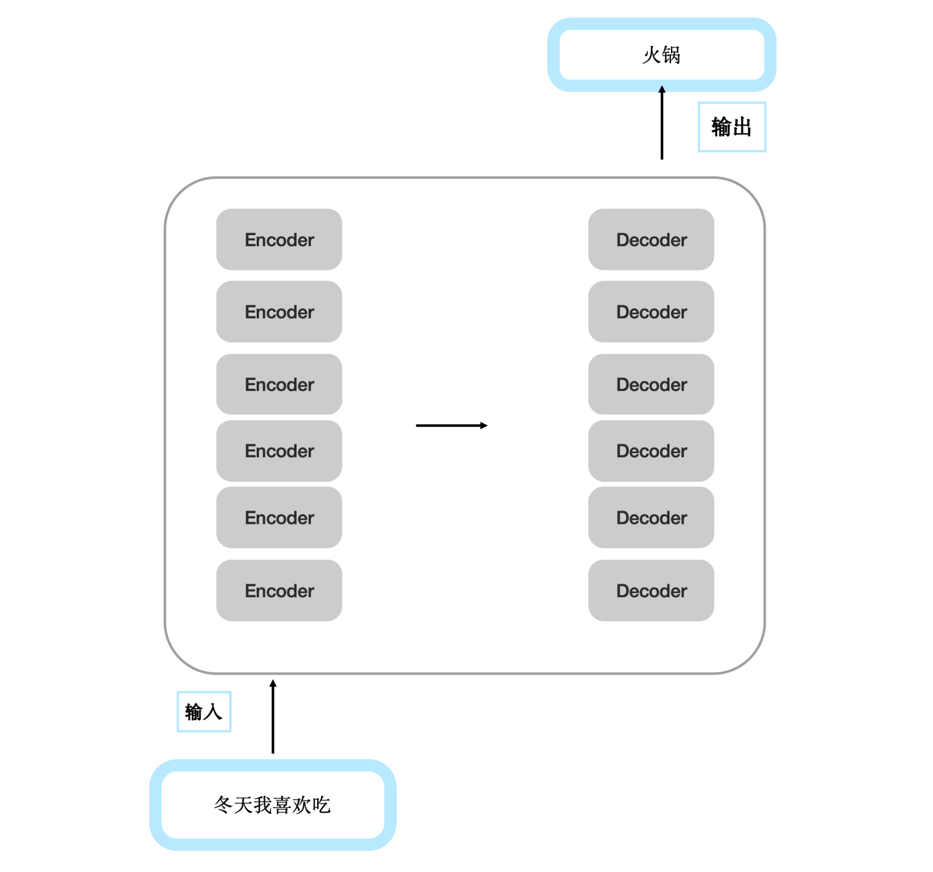
Transformer在做一个什么事情?
核心任务是通过自注意力机制(Self-Attention)高效地建模序列数据中的长距离依赖关系,从而实现对输入数据的深度理解和生成。
核心任务:序列建模与上下文理解
传统模型的局限:
RNN(如LSTM)和CNN在处理长序列时,难以直接捕捉远距离元素间的关系(例如句首和句尾的关联),且计算效率低(需逐步传递隐藏状态)。
Transformer的突破:
通过自注意力机制,直接计算序列中所有元素两两之间的相关性权重,无论距离多远,一步捕获全局依赖关系。
关键操作分解
(1)自注意力机制(Self-Attention)
步骤:
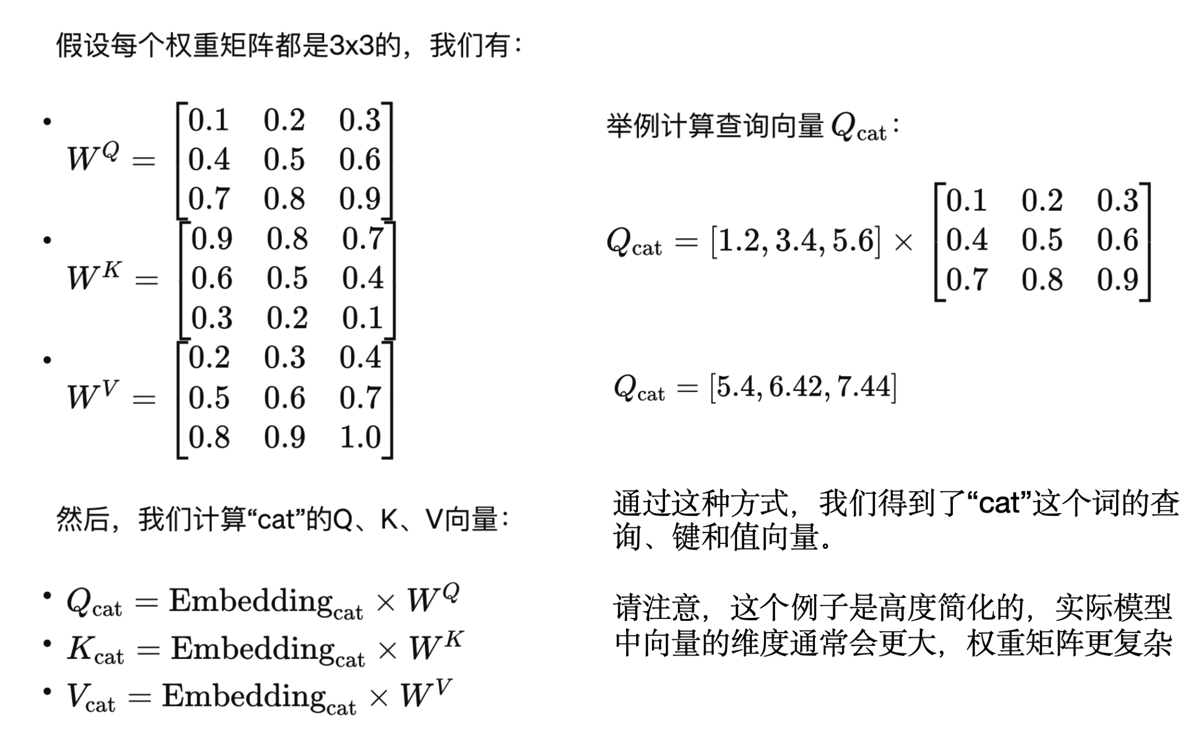
计算Query、Key、Value:将输入向量(如词嵌入)通过线性变换生成三组矩阵(Q, K, V)。
注意力权重:通过Q与K的点积(缩放后)计算元素间相关性,经Softmax归一化得到权重。
加权融合:用权重对V加权求和,得到每个位置的输出(包含全局上下文信息)。
(2)多头注意力(Multi-Head Attention)
并行运行多组自注意力机制,捕捉不同子空间的特征(如语法、语义等),最后拼接结果,增强模型表达能力。
(3)位置编码(Positional Encoding)
Transformer本身无时序处理能力,需通过正弦/余弦函数或可学习参数,为输入注入位置信息,使模型感知序列顺序。
典型应用场景
编码器(Encoder):
适用于理解任务(如文本分类、翻译的编码端),通过多层注意力提取特征。
解码器(Decoder):
适用于生成任务(如文本生成、翻译的解码端),使用掩码注意力(Masked Attention)防止未来信息泄露。
编码器-解码器结构:
机器翻译等任务中,编码器处理输入,解码器基于编码结果生成输出。
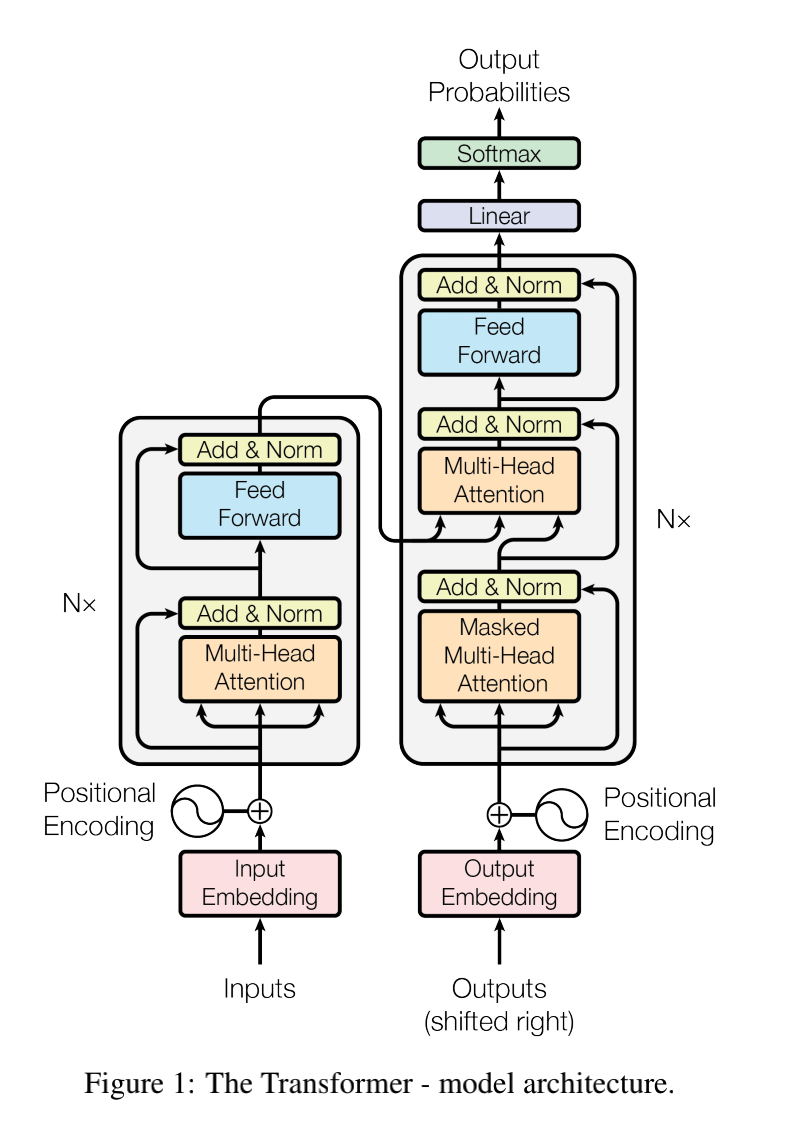
标量、向量、矩阵、张量的关系
- 点——标量(scalar)
- 线——向量(vector)
- 面——矩阵(matrix)
- 体——张量(tensor)
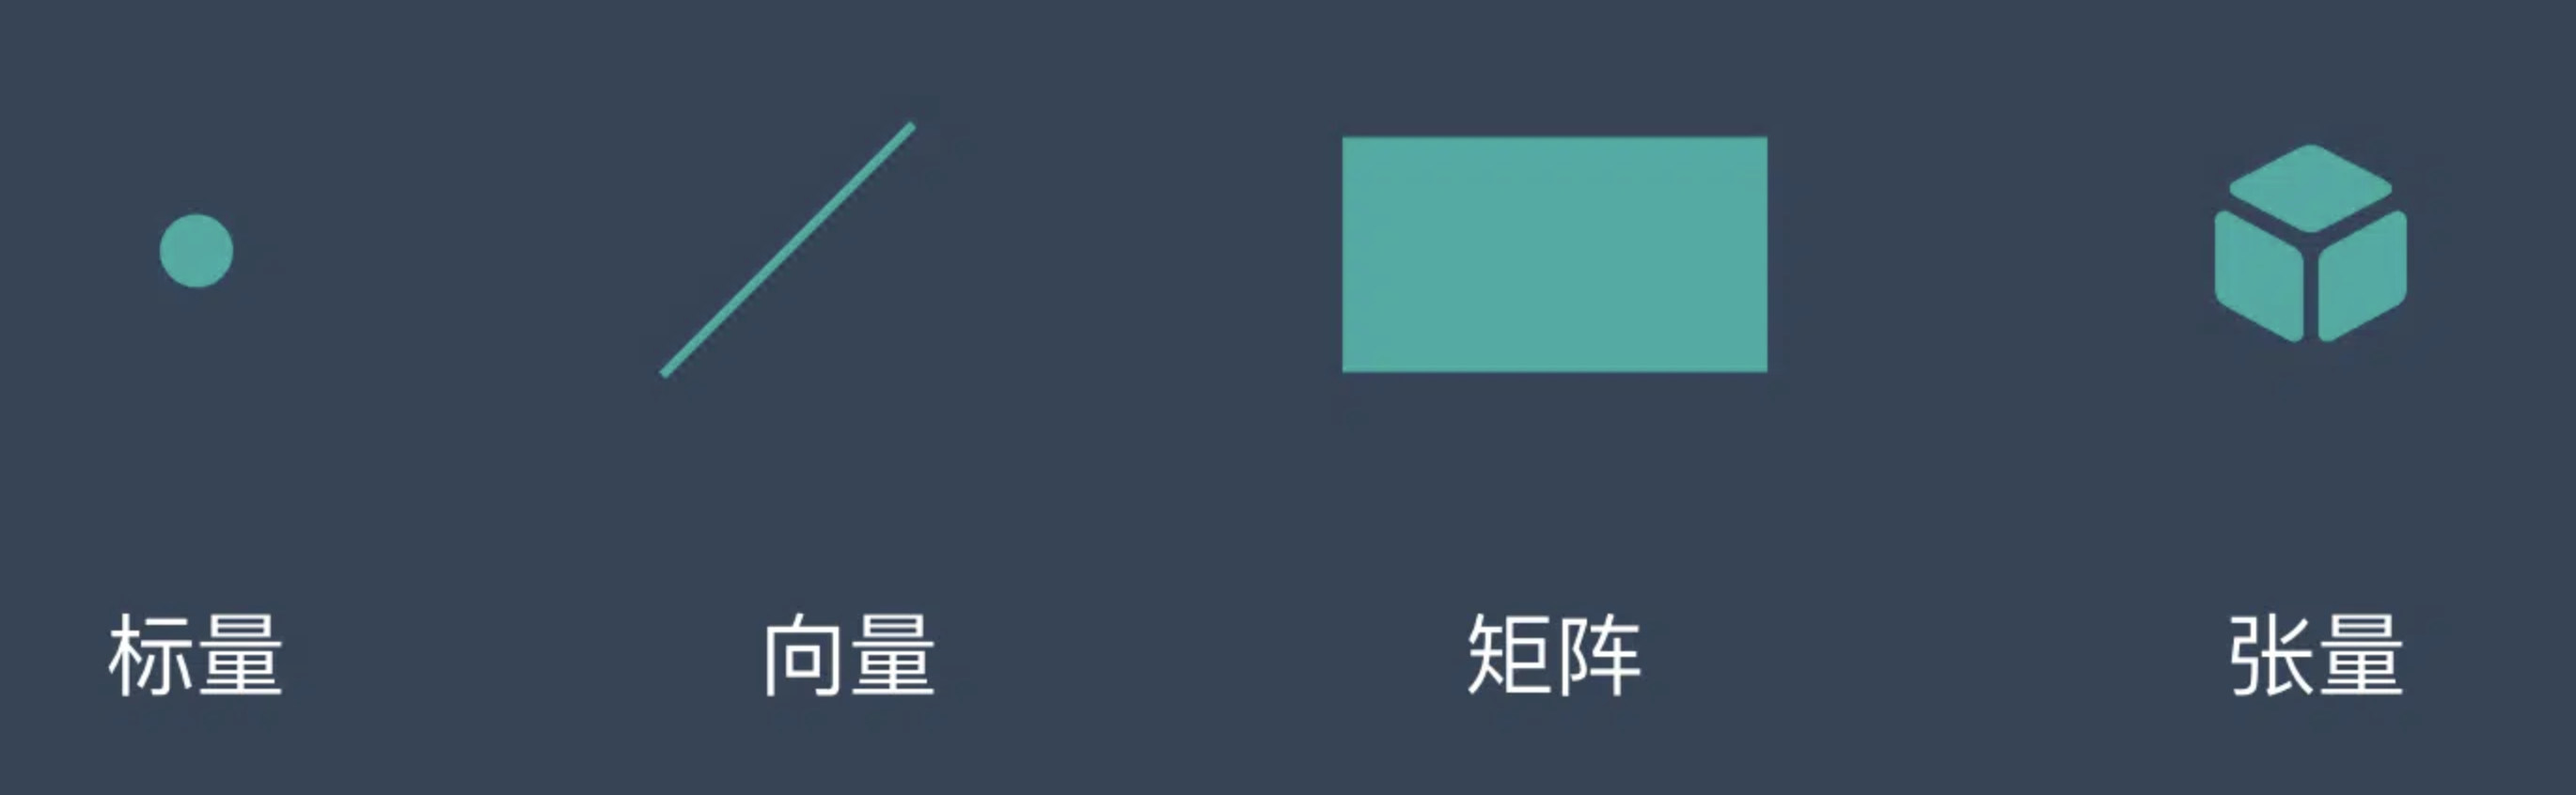
Embedding是什么?
假设我们有一个句子:“The cat sat”
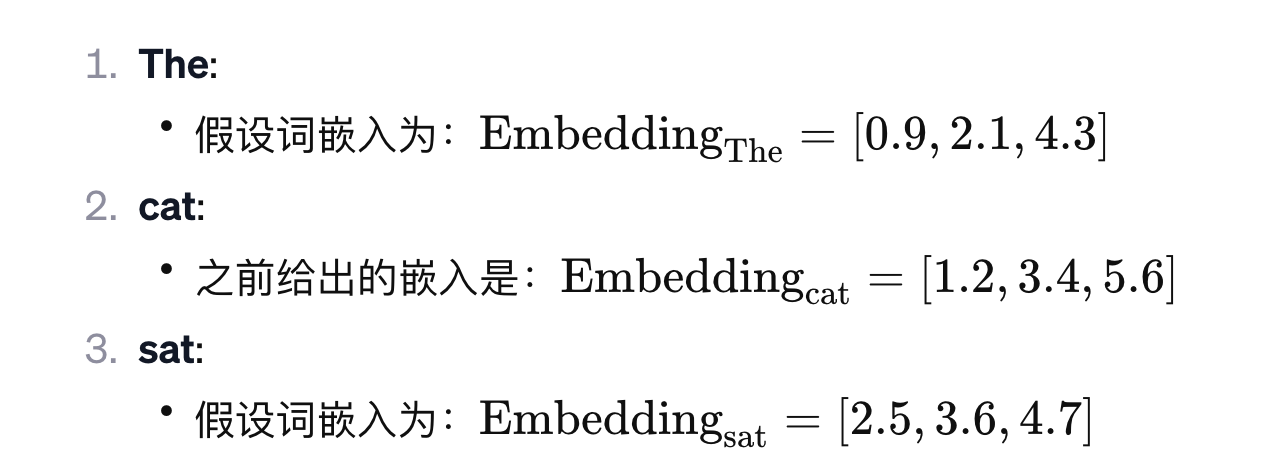
Transformer核心:注意力机制
注意力机制中的Q、K、V
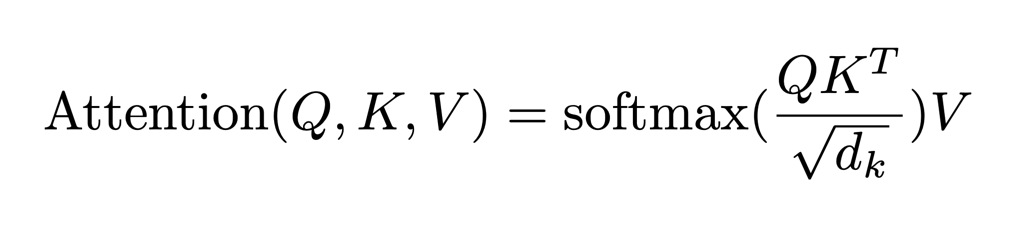
用好 AI 的核心心法
OpenAI 首席科学家 Ilya Sutskever 说过:
数字神经网络和人脑的生物神经网络,在数学原理上是一样的。
所以,我们要:
把 AI 当人看
把 AI 当人看
把 AI 当人看
凯文·凯利说了类似的观点:「和人怎么相处,就和 AI 怎么相处。」
用「当人看」来理解 AI
用「当人看」来控制 AI
用「当人看」来说服别人正确看待 AI 的不足
当什么人呢?
学习时当老师
工作时当助手
休闲时当朋友
这是贯彻整门课的心法,乃至我们与 AI 相伴的人生的心法。
使用大模型的好习惯:
- 使用大模型,不同的话题要开启新的会话;
- 明确指令和问题:尽量使问题或指令简洁明确,避免多重含义或复杂结构,帮助模型更好理解和响应。
- 分步进行:如果问题复杂,可以将问题拆解成几个小问题,逐步处理。这不仅能提高准确度,还能避免模型处理过于庞大的信息。
- 上下文保留:在多个会话中,如果需要参考之前的对话,可以适当提及或复述关键点,避免丢失上下文。
- 分配优先级:针对多个任务或问题,可以为每个话题分配优先级,先处理最重要或最紧急的内容。
- 适应模型的限制:了解模型的处理能力和上下文长度限制,避免在同一会话中输入过长的文本,尤其是如果涉及大量信息时,分割问题会更有效。
- 反馈循环:在与模型交互时,如果模型的回答不完全或不符合预期,可以及时提供反馈和补充说明,让模型逐步优化回答。
- 使用特定的格式或模板:如果是处理特定类型的任务或问题(如代码、数学问题、写作任务),可以为输入提供特定的格式或模板,以帮助模型更准确地理解任务需求。
大模型技术的短板
- 对时效性内容的处理: 由于大型模型通常在某个时间点之前的数据上训练,它们可能无法处理最新的事件或信息。例如,对于最近发生的新闻事件或新兴的流行文化现象,模型可能缺乏理解,GPT4最近最新2023年4月。
- 幻觉、不准确性和滥用风险: 大型模型可能产生“幻觉”,即提供错误但看似合理的文本。这可能导致误信息的传播,甚至被用于非法或不道德目的。例如,恶意使用者可能利用模型生成看似来自可信出版物的文章,作为假新闻传播。
- 泛化能力的局限性: 泛化能力指的是一个模型在处理新的、未见过的数据时的表现能力虽然大型模型在多个任务上表现出色,但在处理特定、罕见或新颖的情况时可能表现不佳
- 难以解释和透明性差: 大型模型通常是“黑箱”,即使是模型的开发者也无法完全理解模型是如何配置自身以产生文本的。这导致了解释或解释AI/ML算法的新框架的发展,但由于模型规模的增大,解释性AI/ML方法变得日益复杂。
大模型应用产品架构
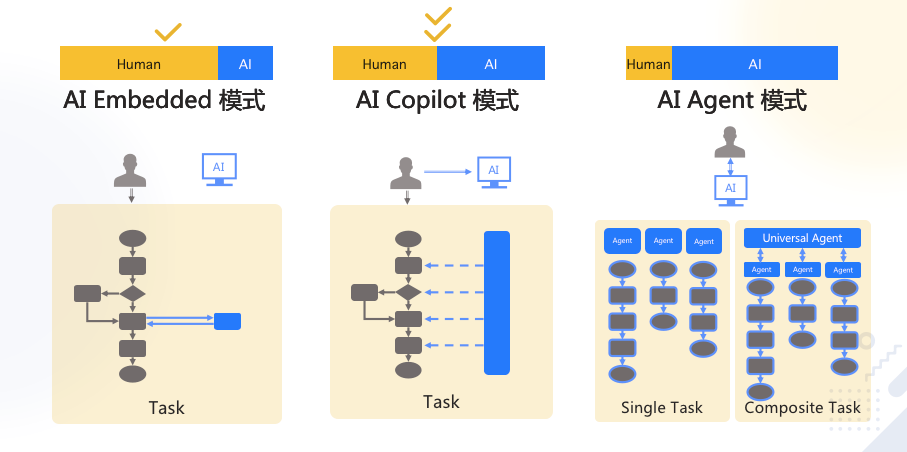
Agent 模式还太超前,Copilot 是当前主流。
实现 Copilot 的主流架构是多 Agent 工作流
- 模仿人做事,将业务拆成工作流(workflow、SOP、pipeline)
- 每个 Agent 负责一个工作流节点
大模型应用技术架构
大模型应用技术特点:门槛低,天花板高。
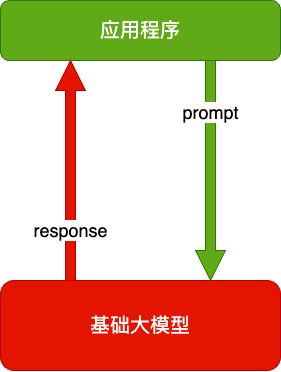
纯 Prompt
- Prompt 是操作大模型的唯一接口
- 当人看:你说一句,ta 回一句,你再说一句,ta 再回一句……
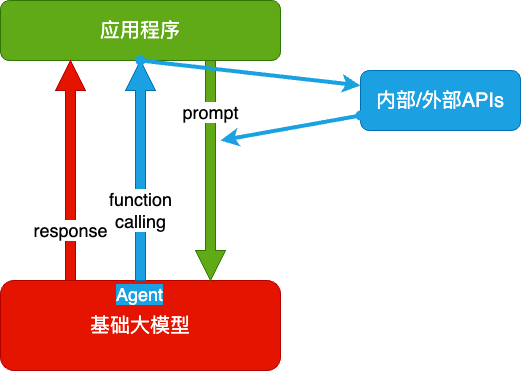
Agent + Function Calling
- Agent:AI 主动提要求
- Function Calling:AI 要求执行某个函数
- 当人看:你问 ta「我明天去杭州出差,要带伞吗?」,ta 让你先看天气预报,你看了告诉 ta,ta 再告诉你要不要带伞
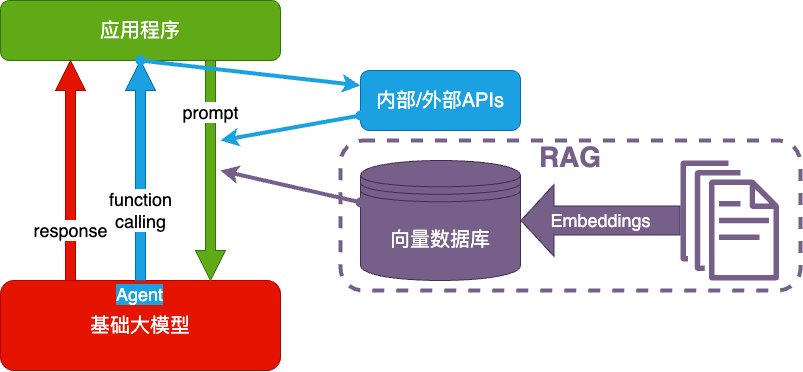
RAG(Retrieval-Augmented Generation)
- Embeddings:把文字转换为更易于相似度计算的编码。这种编码叫向量
- 向量数据库:把向量存起来,方便查找
- 向量搜索:根据输入向量,找到最相似的向量
- 当人看:考试答题时,到书上找相关内容,再结合题目组成答案,然后,就都忘了
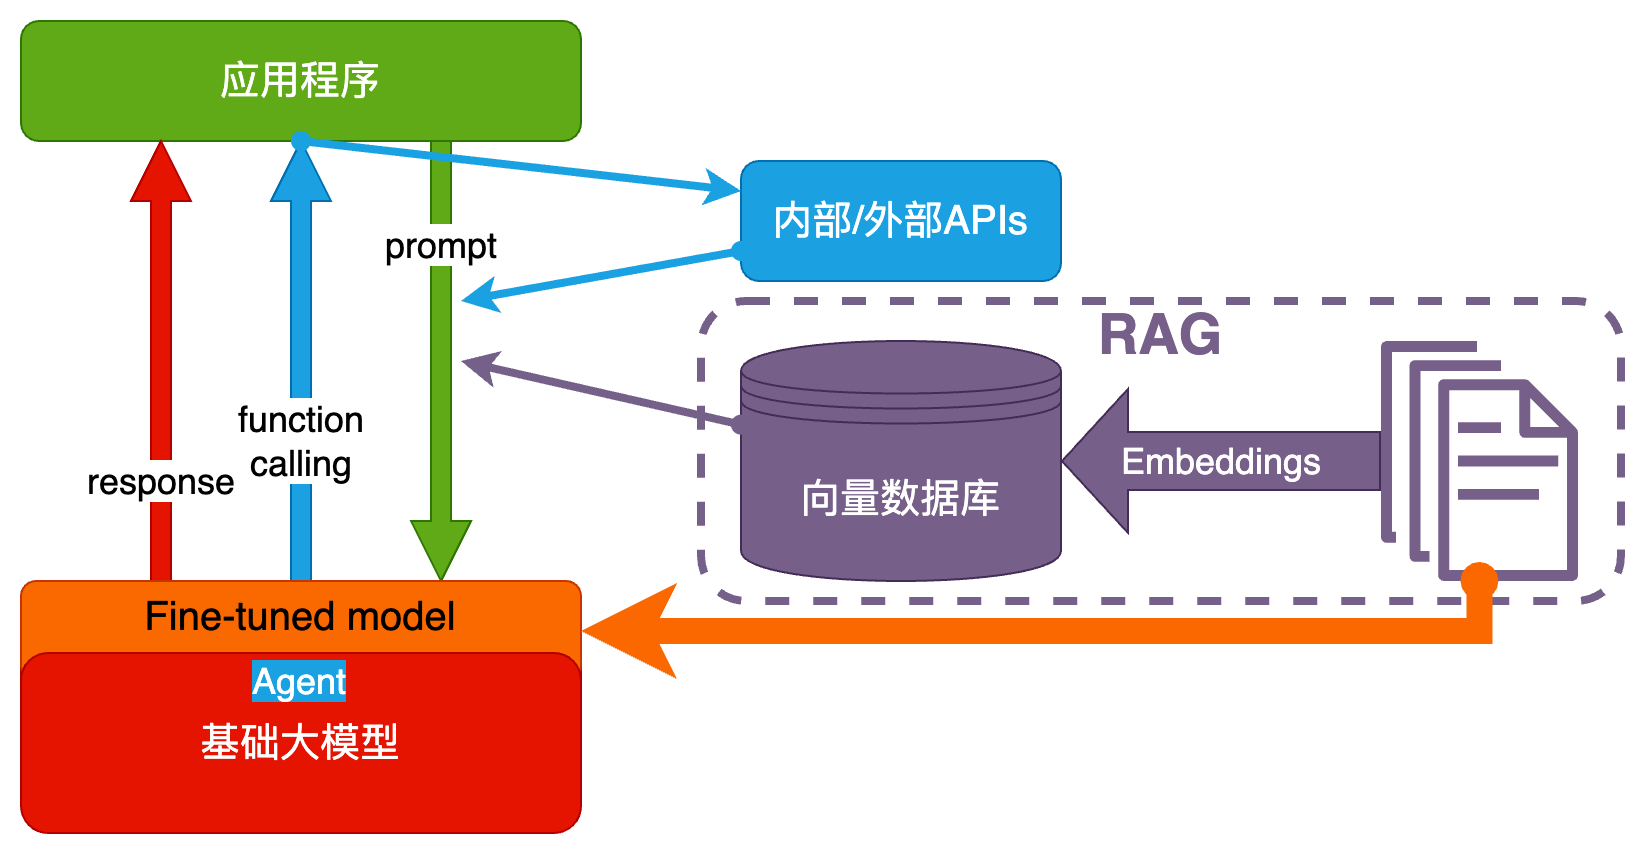
Fine-tuning(精调/微调)
当人看:努力学习考试内容,长期记住,活学活用。
如何选择技术路线
面对一个需求,如何开始,如何选择技术方案?下面是个不严谨但常用思路。
其中最容易被忽略的,是准备测试数据
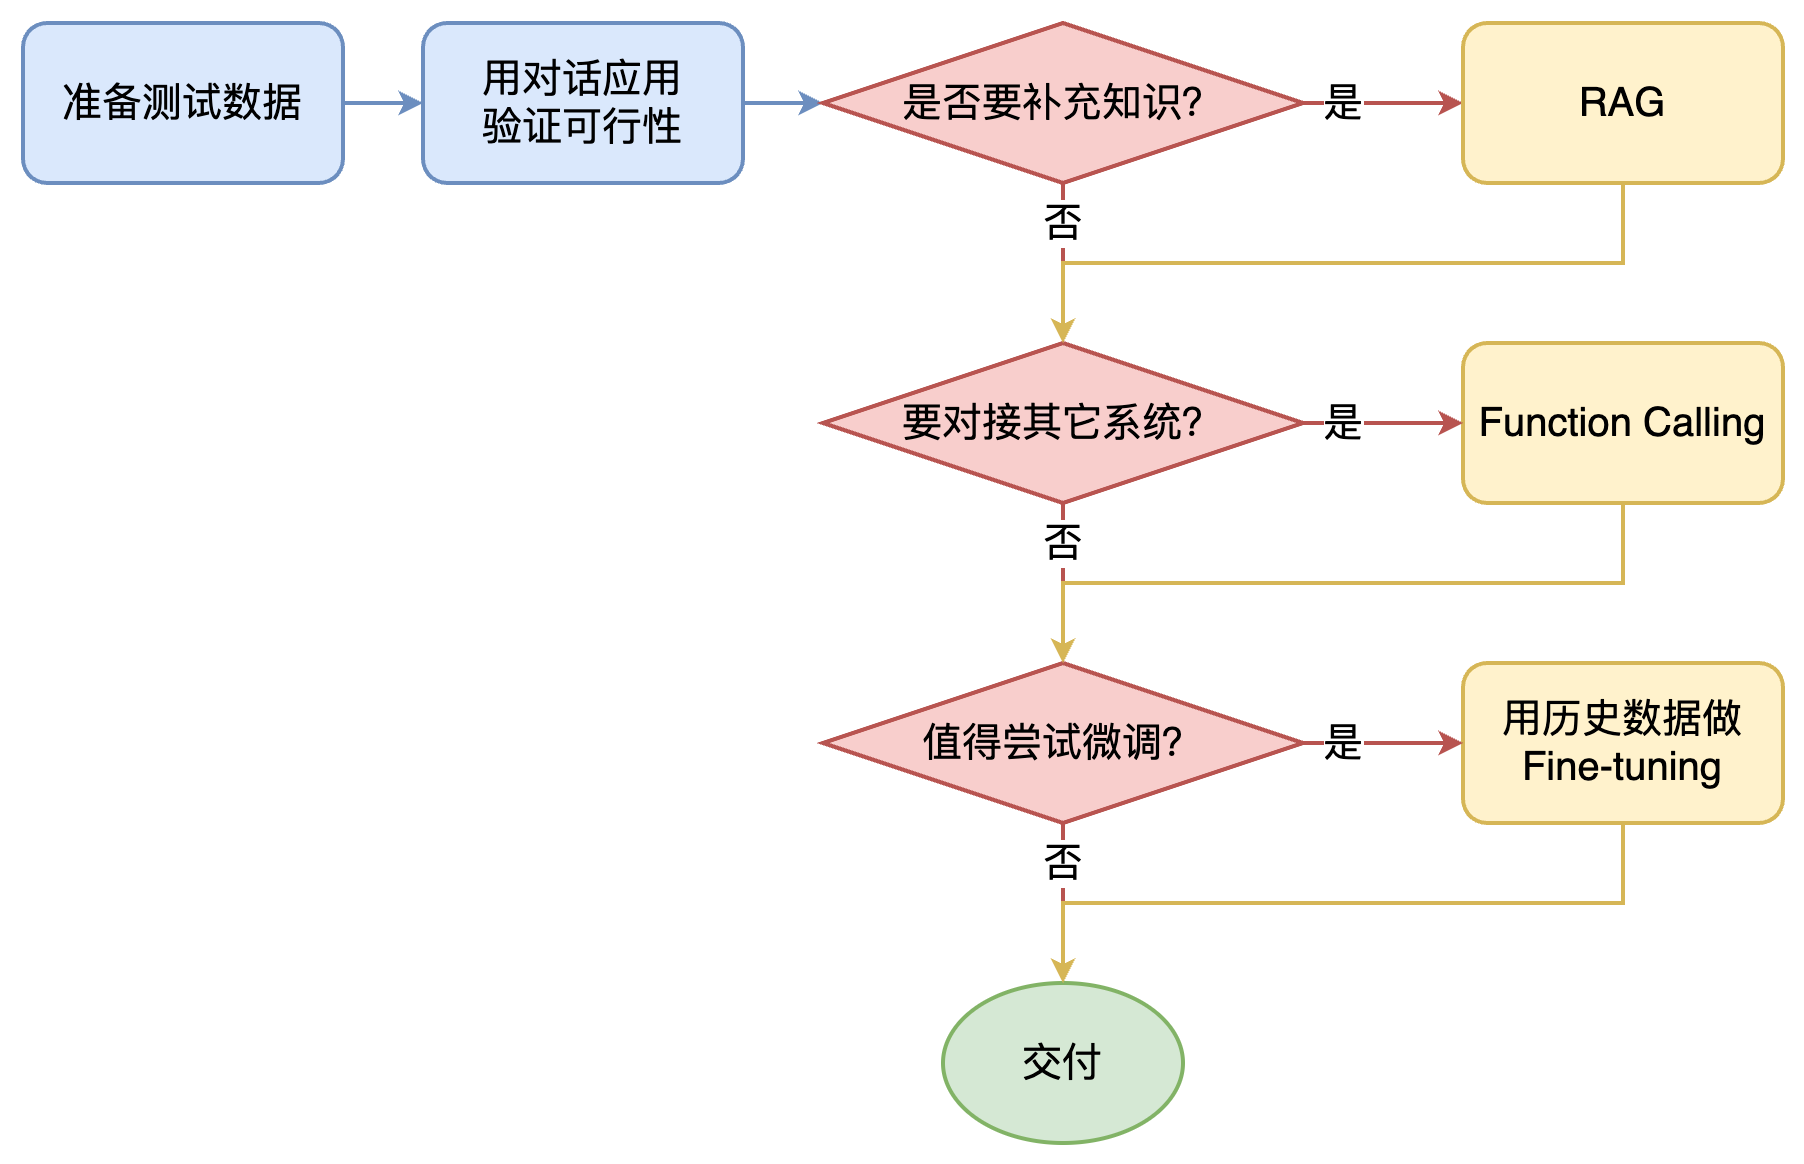
值得尝试 Fine-tuning 的情况:
- 提高模型输出的稳定性
- 用户量大,降低推理成本的意义很大
- 提高大模型的生成速度
- 需要私有部署
实际应用案例:业务流程解构与企业大模型应用
案例 1:智能客服系统优化
1. 业务流程分析
- 现有流程:客户通过电话或在线渠道联系客服,人工客服接听后处理问题。高峰时段,客服人员处理请求的速度较慢,且重复性问题占比高。
- 问题分析:
- 客服响应时间长,客户体验差。
- 高重复性问题,人工客服效率低。
- 客服人员压力大,缺乏足够的资源。
2. 价值流图绘制
- 关键流程:
- 客户请求 -> 人工客服接听 -> 问题解决 -> 客户反馈
- 问题识别:
- 高峰期间等待时间长,人工客服需要处理大量重复问题,缺乏自动化支持。
- 改进点:
- 引入自动化工具(如智能客服)减少人工干预,提升响应速度。
3. 应用大模型
- 自然语言处理(NLP):使用大语言模型(如GPT)构建智能客服系统,支持自然语言理解和生成,自动回答常见问题。
- 工作流:
- 使用NLP识别客户请求意图并进行分类。
- 常见问题通过智能问答系统自动解答。
- 将复杂或不常见问题转接给人工客服。
- 结果:
- 客服响应时间减少50%,客户满意度提高。
- 人工客服压力减轻,更多精力投入到复杂问题处理上。
案例 2:智能供应链与需求预测优化
1. 业务流程分析
- 现有流程:企业生产与库存管理依赖传统的预测模型,按月或季度调整生产计划,库存管理不精确,容易造成库存积压或缺货。
- 问题分析:
- 生产计划与实际需求不匹配,导致产能浪费或供应短缺。
- 库存管理不精准,影响现金流和运营成本。
2. 价值流图绘制
- 关键流程:
- 需求预测 -> 生产计划 -> 原材料采购 -> 产品生产 -> 仓库管理 -> 客户交付
- 问题识别:
- 传统需求预测精度低,库存管理滞后,无法快速响应市场变化。
3. 应用大模型
- 机器学习模型:利用历史销售数据、市场趋势和季节性变化等因素,应用大模型提高需求预测精度。
- 工作流:
- 使用AI进行数据分析和需求预测。
- 自动调整生产排程和采购计划。
- 基于预测结果动态调整库存管理策略。
- 结果:
- 需求预测准确率提高20%,库存积压减少30%。
- 生产和采购计划更加精准,运营成本降低。
案例 3:智能生产线质量控制
1. 业务流程分析
- 现有流程:生产线上的产品质量由人工检测,人工检测存在判断失误和效率低的问题,特别是在高产量情况下,无法及时发现质量问题。
- 问题分析:
- 质量检测依赖人工,容易漏检或误判。
- 高生产速度下无法保证每个产品都得到充分检查,导致次品流入市场。
2. 价值流图绘制
- 关键流程:
- 原材料入库 -> 生产加工 -> 质量检查 -> 产品包装 -> 交付
- 问题识别:
- 人工检查的准确性和效率无法满足生产需求,生产质量无法稳定控制。
3. 应用大模型
- 计算机视觉:使用视觉大模型进行产品质量检测,自动识别产品缺陷。
- 工作流:
- 使用大模型对生产线上每个产品进行图像识别,实时监控产品表面缺陷。
- 对有缺陷的产品进行标记,及时移出生产线,避免流入市场。
- AI实时反馈生产数据给生产线控制系统,优化生产流程。
- 结果:
- 质量检测精度提升至99%,次品率减少80%。
- 整体生产效率提升30%,减少了人工检测的误差和漏检问题。
总结
这三个案例展示了如何通过大模型优化企业业务流程。智能客服、供应链优化和生产线质量控制是大模型应用的重要领域,通过自动化、预测和优化,企业能够提高效率、降低成本,并提供更好的客户体验。通过结合大模型的强大能力,企业可以快速应对变化,提升竞争力。
未来展望
- 大模型竞争的过程继续白热化,第一将会不断轮流切换
- 多模态大模型将更加成熟,大模型的价格将不断走低
- 大模型应用开发才是未来最值的关注的方向,应用为王
更多推荐
 14
 0
- 0


 已为社区贡献1条内容

所有评论(0)